ممکن است یک وبسایت صدها یا هزاران صفحه داشته باشد، اما همه صفحات آن با سرعت یکسان توسط گوگل بررسی نشوند. گاهی صفحات جدید دیر کشف میشوند، بعضی URLها بارها توسط Googlebot درخواست میشوند و تعدادی از صفحات مهم نیز با وجود انتشار و لینکسازی داخلی، بهسرعت مجدداً خزش نمیشوند. در چنین شرایطی، بررسی مفاهیمی مانند Crawl Budget و Crawl Rate میتواند به شناسایی بخشی از مشکلات سئو تکنیکال کمک کند.
این دو اصطلاح به نحوه بررسی صفحات سایت توسط خزندههای موتور جستجو مربوط هستند، اما معنی یکسانی ندارند. Crawl Rate به میزان و سرعت درخواستهای خزنده برای دریافت اطلاعات از سایت اشاره میکند؛ درحالیکه Crawl Budget به مجموعه URLهایی مربوط است که گوگل توانایی و تمایل دارد در یک بازه زمانی آنها را خزش کند.
در این مقاله تفاوت Crawl Budget و Crawl Rate را به زبان ساده توضیح میدهیم، عوامل مؤثر بر هرکدام را بررسی میکنیم و نشان میدهیم چگونه میتوان با استفاده از Google Search Console، بررسی لاگ سرور و اصلاح ساختار سایت، فرآیند خزش را بهینه کرد.

Crawl چیست و گوگل چگونه صفحات سایت را بررسی میکند؟
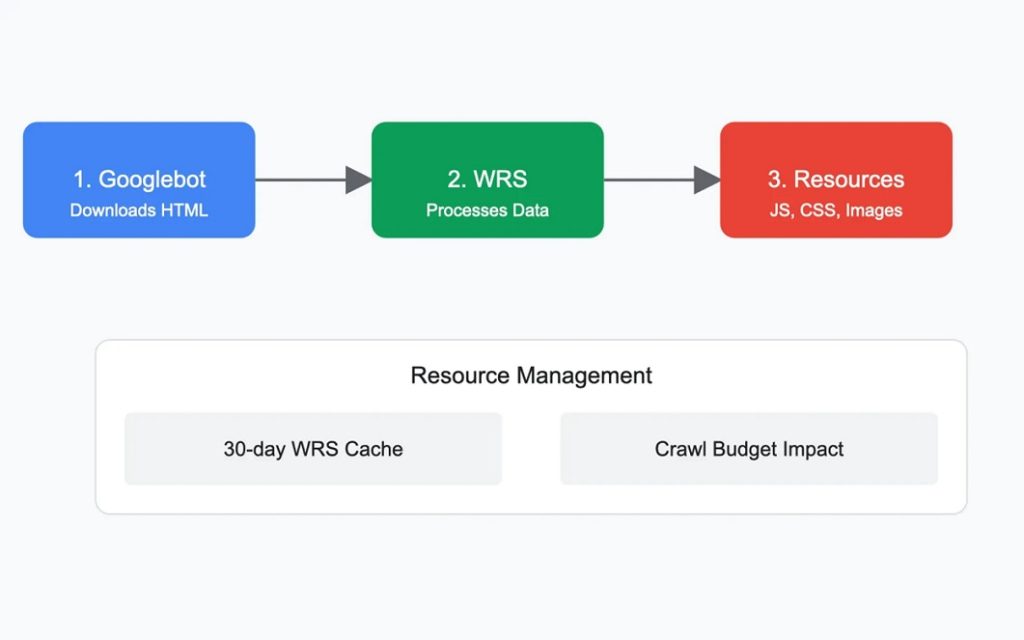
برای درک تفاوت Crawl Budget و Crawl Rate ابتدا باید با مفهوم Crawl آشنا شویم. خزش یا Crawling فرآیندی است که طی آن خزندههای موتورهای جستجو، مانند Googlebot، صفحات و منابع قابل دسترسی وبسایتها را درخواست و بررسی میکنند.
گوگل از طریق لینکهای داخلی، لینکهای خارجی، نقشه سایت و منابع دیگر با URLهای جدید آشنا میشود. سپس در صورت نیاز آنها را خزش میکند تا محتوای صفحه و منابع مرتبط را دریافت کند. پس از خزش، اطلاعات صفحه برای ارزیابی و تصمیمگیری درباره امکان نمایش آن در نتایج جستجو بررسی میشود.
نکته مهم این است که خزش، ایندکس و رتبهگیری سه مرحله یا مفهوم متفاوت هستند. ممکن است گوگل یک صفحه را خزش کند، اما تصمیم بگیرد آن را ایندکس نکند. همچنین ایندکس شدن صفحه به معنای کسب جایگاه مناسب در نتایج جستجو نیست.
Crawl Rate چیست؟
Crawl Rate به سرعت و میزان درخواستهایی گفته میشود که خزنده موتور جستجو برای دریافت صفحات و منابع یک وبسایت ارسال میکند. در مستندات گوگل، مفهوم دقیقتر و فنیتر این موضوع با اصطلاح Crawl Rate Limit یا محدودیت نرخ خزش توضیح داده میشود.
این محدودیت مشخص میکند Googlebot تا چه اندازه میتواند از سرور یک سایت درخواست دریافت اطلاعات داشته باشد؛ از جمله تعداد اتصالهای همزمان و فاصله زمانی بین درخواستها. هدف اصلی این محدودیت آن است که خزش گوگل باعث اختلال در عملکرد سرور و تجربه کاربران واقعی نشود.
برای مثال، فرض کنید یک وبسایت فروشگاهی در شرایط عادی میتواند تعداد مشخصی درخواست همزمان را پاسخ دهد. اگر Googlebot درخواستهای بسیار زیادی در فاصله کوتاه ارسال کند، ممکن است منابع سرور تحت فشار قرار بگیرند. گوگل برای جلوگیری از چنین وضعیتی، میزان خزش را با توجه به وضعیت پاسخگویی سایت تنظیم میکند.
چه عواملی بر Crawl Rate تأثیر میگذارند؟
مهمترین عامل در تعیین محدودیت خزش، وضعیت سروری است که سایت روی آن میزبانی میشود. اگر سرور بتواند درخواستها را سریع و پایدار پاسخ دهد، گوگل ممکن است ظرفیت بیشتری برای خزش در نظر بگیرد. در مقابل، افزایش زمان پاسخگویی یا بروز خطاهای سرور میتواند باعث کاهش تعداد درخواستهای Googlebot شود.
مهمترین عوامل مؤثر عبارتاند از:
- سرعت پاسخگویی سرور: اگر سرور درخواستهای Googlebot را با تأخیر پاسخ دهد، توان خزش ممکن است کاهش پیدا کند.
- خطاهای سرور: افزایش خطاهای HTTP 5xx و مشکلاتی مانند Timeout میتواند نشانه ناپایداری سرور باشد.
- محدودیت منابع میزبانی: کمبود CPU، حافظه، پهنای باند یا ظرفیت پردازش درخواستها میتواند پاسخگویی به خزندهها را دشوار کند.
- محدودیتهای نرخ درخواست: پاسخهای HTTP 429 یا سایر محدودیتهای اعمالشده توسط سرور و لایههای امنیتی ممکن است باعث کاهش خزش شوند.
- تنظیمات و تصمیمهای خود گوگل: Googlebot بهصورت خودکار میزان درخواستها را با توجه به شرایط سایت و نیازهای خزش تنظیم میکند.
بنابراین Crawl Rate فقط به تعداد صفحات سایت وابسته نیست. ممکن است دو وبسایت با تعداد URL مشابه، به دلیل تفاوت در کیفیت سرور و میزان تقاضای خزش، نرخ خزش متفاوتی داشته باشند.
Crawl Budget چیست؟
Crawl Budget یا بودجه خزش به مجموعه URLهایی گفته میشود که گوگل در یک بازه زمانی مشخص توانایی و تمایل دارد آنها را بررسی کند. این مفهوم صرفاً به تعداد درخواستهایی که Googlebot در روز ارسال میکند محدود نیست، بلکه به ظرفیت خزش سایت و میزان تقاضای گوگل برای بررسی URLهای آن نیز بستگی دارد.
گوگل برای هر سایت منابع نامحدودی در اختیار ندارد. از طرف دیگر، همه URLهای یک وبسایت نیز ارزش یکسانی برای خزش ندارند. ممکن است یک سایت هزاران آدرس مختلف داشته باشد، اما فقط بخشی از آنها صفحات اصلی، محتوای ارزشمند یا محصولات مهم باشند.
اگر تعداد زیادی URL تکراری، کمارزش یا غیرضروری در دسترس خزنده قرار بگیرند، بخشی از فعالیت خزش ممکن است صرف بررسی همین آدرسها شود. به همین دلیل، مدیریت URLهای سایت و هدایت خزنده به سمت صفحات مهم، در بهینهسازی Crawl Budget اهمیت دارد.

Crawl Budget از چه دو بخش اصلی تشکیل میشود؟
در توضیحات فنی گوگل، بودجه خزش با در نظر گرفتن دو مؤلفه اصلی تعریف میشود: Crawl Capacity Limit و Crawl Demand. این دو مؤلفه مشخص میکنند گوگل چه میزان توانایی برای خزش سایت دارد و تا چه اندازه تمایل دارد URLهای آن را بررسی کند.
۱. Crawl Capacity Limit؛ ظرفیت خزش سایت
ظرفیت خزش مشخص میکند خزنده گوگل تا چه اندازه میتواند بدون ایجاد فشار نامناسب بر سرور، از سایت درخواست دریافت کند. این ظرفیت با توجه به وضعیت سرور و شرایط پاسخگویی آن تغییر میکند.
برای مثال، اگر یک وبسایت در بیشتر مواقع سریع و پایدار باشد، امکان افزایش ظرفیت خزش آن وجود دارد. اما اگر سرور با کندی، قطعی یا خطاهای مکرر مواجه شود، گوگل ممکن است تعداد درخواستها را کاهش دهد تا فشار بیشتری به سایت وارد نشود.
در واقع، Crawl Capacity Limit ارتباط نزدیکی با سلامت فنی سایت و منابع میزبانی دارد و بخشی از آن به کنترل خودکار Googlebot برای جلوگیری از فشار بیش از حد بر سرور مربوط میشود.
۲. Crawl Demand؛ میزان تقاضای خزش
تقاضای خزش مشخص میکند گوگل تا چه اندازه به بررسی مجدد یا کشف URLهای یک سایت نیاز دارد. حتی اگر سرور ظرفیت پاسخگویی به تعداد زیادی درخواست را داشته باشد، در صورت پایین بودن تقاضای خزش، لزوماً تعداد درخواستهای Googlebot افزایش پیدا نمیکند.
برخی از عوامل مؤثر بر Crawl Demand عبارتاند از:
- محبوبیت صفحات: URLهایی که در فضای وب محبوبتر هستند و سیگنالهای بیشتری از اهمیت آنها وجود دارد، ممکن است بیشتر مورد توجه خزنده قرار بگیرند.
- میزان تغییر محتوا: اگر صفحهای مرتب بهروزرسانی شود، گوگل ممکن است برای مشاهده تغییرات به خزش مجدد آن نیاز داشته باشد.
- اندازه و ساختار سایت: تعداد URLهای قابل کشف و نحوه سازماندهی آنها بر میزان فعالیت خزنده تأثیر میگذارد.
- ارزش و ارتباط صفحات: کیفیت و میزان مفید بودن محتوای سایت در تصمیمهای گوگل درباره تقاضای خزش نقش دارد.
- تغییرات گسترده در سایت: برای مثال، تغییر دامنه یا انتقال ساختار URLها ممکن است نیاز گوگل به بررسی مجدد صفحات را افزایش دهد.
بنابراین، بالا بودن ظرفیت سرور بهتنهایی به معنای دریافت بودجه خزش بیشتر نیست. گوگل باید علاوه بر توانایی فنی سایت، دلیلی برای بررسی تعداد بیشتری از URLهای آن داشته باشد.
تفاوت Crawl Budget و Crawl Rate به زبان ساده
برای درک بهتر تفاوت این دو مفهوم، یک کتابخانه بزرگ را در نظر بگیرید. تعداد کتابهایی که یک کتابدار میتواند در هر ساعت بررسی کند، به سرعت و توان کاری او مربوط است. اما تعداد کتابهایی که واقعاً لازم است بررسی شوند و اولویت دارند، به نیاز و ارزش آنها بستگی دارد.
در این مثال، Crawl Rate به سرعت و ظرفیت بررسی درخواستها شباهت دارد و Crawl Budget به مجموعه صفحاتی مربوط است که گوگل توانایی و تمایل دارد آنها را خزش کند. به همین دلیل، افزایش سرعت خزش الزاماً باعث نمیشود تعداد بیشتری از صفحات سایت در نتایج جستجو قرار بگیرند.
| معیار مقایسه | Crawl Rate | Crawl Budget |
|---|---|---|
| تعریف | سرعت و میزان درخواستهای خزنده برای دریافت اطلاعات | مجموعه URLهایی که گوگل توانایی و تمایل به خزش آنها دارد |
| تمرکز اصلی | تعداد درخواستها، اتصالهای همزمان و فاصله درخواستها | ظرفیت خزش و تقاضای بررسی URLها |
| عوامل مؤثر | سلامت سرور، زمان پاسخ، خطاها و محدودیت درخواست | ظرفیت سرور، کیفیت و محبوبیت صفحات، تغییر محتوا و URLهای قابل خزش |
| هدف بهینهسازی | حفظ خزش پایدار بدون فشار بیش از حد بر سرور | استفاده مؤثر از منابع خزش برای URLهای مهم |
| ابزار بررسی | گزارش Crawl Stats و لاگ سرور | تحلیل URLها، گزارشهای خزش، لاگ سرور و وضعیت ایندکس |
| ارتباط با رتبه | افزایش نرخ خزش بهتنهایی رتبه را بالا نمیبرد | مدیریت مناسب خزش میتواند به کشف و پردازش بهتر صفحات مهم کمک کند |
نکته کلیدی این است که Crawl Rate یکی از محدودیتهای مرتبط با ظرفیت خزش است، اما Crawl Budget فقط با نرخ درخواست تعیین نمیشود. میزان تقاضای گوگل برای بررسی صفحات نیز در آن نقش دارد.
Crawl Budget و Crawl Rate چه تأثیری بر سئو سایت دارند؟
خزش یکی از مراحل ضروری برای حضور صفحات در نتایج جستجو است. اگر گوگل نتواند صفحهای را کشف و خزش کند، امکان ارزیابی محتوای آن برای ایندکس شدن نیز با مشکل روبهرو خواهد شد. با این حال، نباید تصور کرد افزایش Crawl Rate یا Crawl Budget بهصورت مستقیم باعث بهبود رتبه سایت میشود.
تأثیر اصلی مدیریت صحیح خزش، بهبود دسترسی خزنده به صفحات مهم، کاهش درخواستهای غیرضروری و کمک به کشف و بهروزرسانی مناسبتر محتوا است. این موضوع برای سایتهای بزرگ و پرتغییر اهمیت بیشتری دارد.
۱. کشف سریعتر صفحات جدید
وقتی ساختار لینکسازی داخلی مناسب باشد و URLهای مهم از طریق نقشه سایت و لینکهای قابل خزش در دسترس قرار بگیرند، گوگل راحتتر میتواند آنها را کشف کند. این موضوع بهویژه برای سایتهای خبری، فروشگاههای اینترنتی و وبسایتهایی که مرتب محتوای جدید منتشر میکنند اهمیت دارد.
۲. بهروزرسانی سریعتر صفحات تغییر یافته
فرض کنید قیمت محصولات یک فروشگاه اینترنتی مرتب تغییر میکند. اگر صفحات مهم بهدرستی در دسترس خزنده باشند و گوگل آنها را بهموقع دوباره خزش کند، شانس پردازش اطلاعات جدید در زمان مناسب بیشتر خواهد بود. البته زمان نمایش تغییرات در نتایج جستجو تضمینشده نیست و به ارزیابیهای بعدی گوگل نیز بستگی دارد.
۳. کاهش اتلاف منابع خزش
وجود هزاران URL تکراری یا کمارزش میتواند باعث شود خزنده درخواستهای زیادی برای آدرسهایی ارسال کند که ارزش مستقلی برای جستجو ندارند. مدیریت این URLها به گوگل کمک میکند منابع خزش را به شکل مؤثرتری در سایت مصرف کند.
۴. شناسایی مشکلات فنی و سرور
بررسی نرخ خزش و پاسخهای سرور میتواند نشانههایی از مشکلاتی مانند کندی هاست، خطاهای ۵۰۰، محدودیت درخواست یا اختلال در دسترسی Googlebot را مشخص کند. رفع این مشکلات علاوه بر کمک به خزش، برای پایداری سایت و تجربه کاربران واقعی نیز اهمیت دارد.
چه سایتهایی بیشتر به مدیریت Crawl Budget نیاز دارند؟
مدیریت بودجه خزش برای تمام وبسایتها به یک اندازه ضروری نیست. طبق مستندات فعلی گوگل، این موضوع بیشتر برای سایتهای بسیار بزرگ یا وبسایتهایی اهمیت دارد که تعداد زیادی صفحه را بهسرعت تغییر میدهند.
گوگل بهعنوان نمونه، سایتهای دارای بیش از یک میلیون URL یکتا با تغییرات متوسط و سایتهای متوسط یا بزرگ با بیش از ۱۰ هزار URL یکتا و تغییرات روزانه را از مواردی میداند که ممکن است به بررسی جدیتر Crawl Budget نیاز داشته باشند. این اعداد آستانه قطعی نیستند، بلکه معیارهای تقریبی برای تشخیص سایتهای نیازمند مدیریت پیشرفته خزش هستند.
مهمترین گروههای سایت که بهتر است وضعیت خزش خود را دقیقتر بررسی کنند عبارتاند از:
- فروشگاههای اینترنتی بزرگ با تعداد زیاد محصول، دستهبندی و فیلترهای جستجو
- وبسایتهای خبری با انتشار روزانه تعداد زیادی خبر
- سایتهای آگهی و نیازمندیها با صفحات متعدد و محتوای متغیر
- پلتفرمهای دارای پروفایل کاربران و صفحات تولیدشده بهصورت خودکار
- وبسایتهای چندزبانه یا چندمنطقهای با URLهای متعدد
- سایتهایی که بخش زیادی از صفحات آنها در گزارش ایندکس با وضعیت «Discovered – currently not indexed» دیده میشوند
در مقابل، اگر سایت شما یک وبسایت شرکتی یا خدماتی با چند ده یا چند صد صفحه است و صفحات جدید آن در زمان معقول کشف میشوند، معمولاً نیازی به درگیر شدن با تنظیمات پیچیده بودجه خزش ندارید. در چنین سایتهایی، رسیدگی به نقشه سایت، لینکسازی داخلی، کیفیت محتوا و مشکلات ایندکس اولویت بیشتری دارد.
چه عواملی باعث هدررفت Crawl Budget میشوند؟
یکی از مهمترین دلایل استفاده ناکارآمد از منابع خزش، وجود URLهایی است که اطلاعات ارزشمند یا محتوای مستقلی ندارند، اما همچنان در دسترس خزنده قرار میگیرند. این مشکل در سایتهایی که با سیستمهای مدیریت محتوا و فروشگاهسازها ساخته شدهاند، گاهی به دلیل تولید خودکار آدرسهای متعدد رخ میدهد.
۱. URLهای تکراری و محتوای مشابه
اگر یک محتوا از طریق چند آدرس مختلف در دسترس باشد، ممکن است گوگل برای بررسی URLهای مختلف درخواست ارسال کند؛ درحالیکه این صفحات محتوای یکسان یا بسیار مشابهی دارند.
برای مثال، ممکن است یک محصول از طریق URL اصلی و چند آدرس دارای پارامترهای مختلف در دسترس باشد. استفاده از Canonical صحیح و اصلاح ساختار URLها میتواند به مشخص شدن نسخه اصلی کمک کند. البته تگ Canonical یک راهنمای ترجیحی برای انتخاب URL اصلی است و بهتنهایی مانع خزش نسخههای دیگر نمیشود.
۲. فیلترها و پارامترهای غیرضروری در فروشگاه اینترنتی
فروشگاههای اینترنتی معمولاً امکان فیلتر محصولات بر اساس قیمت، رنگ، برند، اندازه و سایر ویژگیها را دارند. در بعضی پیادهسازیها، هر ترکیب از فیلترها یک URL جدید ایجاد میکند. اگر تعداد این ترکیبها زیاد باشد، ممکن است هزاران آدرس مشابه و کمارزش در سایت به وجود بیاید.
برای نمونه، یک فروشگاه پوشاک ممکن است برای ترکیبهای مختلف رنگ، سایز، برند و محدوده قیمت، URLهای متعددی بسازد. اگر همه این آدرسها برای خزش آزاد باشند و ارزش جستجوی مستقلی نداشته باشند، میتوانند منابع خزش را مصرف کنند.
راهکار مناسب، بررسی رفتار فیلترها و تصمیمگیری درباره URLهایی است که واقعاً باید در نتایج جستجو حضور داشته باشند. نباید همه صفحات فیلتر را بدون تحلیل مسدود کرد؛ بعضی از آنها ممکن است تقاضای جستجوی مستقل و ارزش واقعی داشته باشند.
۳. صفحات جستجوی داخلی سایت
بعضی سایتها برای هر جستجوی داخلی کاربر یک URL تولید میکنند. اگر این آدرسها بهصورت گسترده توسط خزنده کشف شوند، ممکن است تعداد زیادی صفحه کمارزش یا تکراری ایجاد شود. بهتر است صفحات نتایج جستجوی داخلی، از نظر قابلیت خزش و ایندکس شدن بررسی شوند و در صورت نیاز، دسترسی خزنده به آنها مدیریت شود.
۴. زنجیره ریدایرکت و ریدایرکتهای غیرضروری
اگر یک URL ابتدا به آدرس دوم و سپس به آدرس سوم منتقل شود، خزنده باید چند درخواست برای رسیدن به مقصد نهایی ارسال کند. وجود زنجیرههای طولانی ریدایرکت باعث افزایش درخواستهای غیرضروری و پیچیده شدن مسیر خزش میشود.
بهتر است ریدایرکتها تا حد امکان مستقیم باشند؛ یعنی آدرس قدیمی بهجای عبور از چند URL، مستقیماً به مقصد نهایی منتقل شود. همچنین ریدایرکتهای شکسته و حلقههای انتقال باید شناسایی و اصلاح شوند.
۵. صفحات خطا و URLهای حذفشده
وجود تعداد زیادی URL با پاسخ ۴۰۴، صفحات Soft 404 و آدرسهایی که محتوای مفیدی ندارند، میتواند نشانهای از ضعف در مدیریت ساختار سایت باشد. اگر این آدرسها از لینکهای داخلی، نقشه سایت یا منابع دیگر مرتب کشف شوند، درخواستهای غیرضروری ایجاد میکنند.
البته پاسخ ۴۰۴ برای صفحهای که واقعاً حذف شده و جایگزین مناسبی ندارد، لزوماً اشتباه نیست. هدف این نیست که همه خطاهای ۴۰۴ را به صفحه اصلی ریدایرکت کنیم؛ بلکه باید لینکهای شکسته داخلی و آدرسهای اشتباه را اصلاح کرد و برای صفحات حذفشده تصمیم درست گرفت.
۶. ساختار ضعیف لینکسازی داخلی
اگر صفحات مهم سایت از طریق لینکهای داخلی مناسب در دسترس نباشند، کشف آنها برای خزنده دشوارتر میشود. این مسئله بهویژه زمانی اهمیت دارد که صفحات جدید فقط در نقشه سایت ثبت شده باشند، اما هیچ مسیر لینک داخلی مناسبی به آنها وجود نداشته باشد.
ایجاد ساختار منطقی دستهبندیها، لینک دادن از صفحات مرتبط و کاهش عمق دسترسی به صفحات مهم، به کشف بهتر URLها کمک میکند. لینک داخلی باید برای کاربران نیز مفید باشد و صرفاً با هدف افزایش تعداد لینکها ساخته نشود.
چگونه Crawl Budget و Crawl Rate سایت را بررسی کنیم؟
برای بررسی وضعیت خزش، باید از ابزارهای مختلف استفاده کنید. Google Search Console اطلاعات مناسبی درباره درخواستهای Googlebot و وضعیت دسترسی سرور ارائه میدهد؛ اما برای تشخیص دقیق اینکه کدام URLها در چه زمانی درخواست شدهاند، بررسی لاگ خام سرور نیز اهمیت دارد.
۱. بررسی گزارش Crawl Stats در سرچ کنسول
یکی از مهمترین ابزارها برای مشاهده فعالیت خزنده گوگل، گزارش Crawl Stats در Google Search Console است. برای دسترسی به این گزارش، وارد سرچ کنسول شوید، Property موردنظر را انتخاب کنید و از بخش Settings روی گزینه Crawl stats کلیک کنید.
این گزارش اطلاعات مختلفی درباره تاریخچه خزش سایت ارائه میدهد، از جمله:
- Total crawl requests: تعداد کل درخواستهای خزش ثبتشده در بازه گزارش
- Total download size: مجموع حجم اطلاعات دریافتشده توسط خزنده
- Average response time: میانگین زمان پاسخگویی سرور به درخواستهای خزش
- Host status: وضعیت دسترسی و سلامت میزبان از نظر Googlebot
- Crawl responses: توزیع پاسخهای HTTP مانند ۲۰۰، ۳۰۱، ۴۰۴ و خطاهای سرور
- File type: نوع منابع دریافتشده مانند HTML، تصویر، CSS و JavaScript
- Crawl purpose: تفکیک درخواستهای مربوط به کشف URL جدید و خزش مجدد صفحات شناختهشده
- Googlebot type: نوع خزندهای که درخواست را ارسال کرده است.
این گزارش برای بررسی روند کلی خزش و شناسایی مشکلات دسترسی مفید است. توجه داشته باشید که Crawl Stats برای Propertyهای سطح ریشه در سرچ کنسول در دسترس است و فهرست URLهای نمونه آن، تاریخچه کامل خزش تکتک صفحات سایت محسوب نمیشود.
همچنین گوگل اعلام کرده است که اگر سایت کمتر از حدود هزار صفحه داشته باشد، معمولاً نیازی نیست مدیر سایت بهصورت تخصصی درگیر این سطح از تحلیل خزش شود؛ مگر اینکه نشانه مشخصی از مشکل دسترسی یا کشف صفحات وجود داشته باشد.
۲. بررسی لاگ سرور برای شناسایی درخواستهای Googlebot
لاگ سرور یکی از دقیقترین منابع برای تحلیل رفتار خزندهها است. در فایل Access Log معمولاً اطلاعاتی مانند URL درخواستشده، زمان درخواست، User-Agent، کد پاسخ HTTP و IP درخواستکننده ثبت میشود.
با بررسی این اطلاعات میتوانید متوجه شوید Googlebot بیشتر به کدام بخشهای سایت مراجعه میکند، چه تعداد درخواست به صفحات مهم ارسال میشود و آیا زمان زیادی صرف URLهای فیلتر، پارامترها یا صفحات غیرضروری شده است.
یک نکته امنیتی مهم وجود دارد: هر درخواستی که در User-Agent خود عبارت Googlebot را داشته باشد، الزاماً متعلق به گوگل نیست. رباتهای جعلی میتوانند این عنوان را جعل کنند. برای تحلیل دقیق، باید IP درخواستکننده را با روشهای رسمی تأیید Googlebot بررسی کنید.
۳. استفاده از ابزار URL Inspection
ابزار URL Inspection در سرچ کنسول به شما اجازه میدهد وضعیت یک URL مشخص را بررسی کنید. از طریق این ابزار میتوانید اطلاعاتی درباره وضعیت ایندکس، نسخه Canonical انتخابشده توسط گوگل و امکان دسترسی خزنده به صفحه مشاهده کنید.
این ابزار برای بررسی نمونهای از صفحات مهم و تشخیص مشکلات احتمالی مفید است، اما جایگزین گزارش Crawl Stats یا تحلیل لاگ سرور برای بررسی رفتار کلی خزنده در کل سایت نیست.
چگونه Crawl Budget را در وردپرس بهینه کنیم؟
وردپرس بهصورت پیشفرض ساختار مشخصی برای مدیریت محتوا، دستهبندیها، برچسبها و آرشیوها دارد. با نصب افزونههای مختلف و توسعه امکانات سایت، ممکن است URLهای متعددی نیز ایجاد شوند. اگر این ساختار بدون برنامهریزی مدیریت شود، تعداد زیادی آدرس مشابه یا کمارزش در دسترس خزنده قرار میگیرد.
برای بهینهسازی خزش در سایتهای وردپرسی، اقدامات زیر میتوانند مفید باشند:
۱. مدیریت صفحات آرشیو و دستهبندیها
در وردپرس ممکن است برای دستهبندیها، برچسبها، نویسندگان، تاریخ انتشار و انواع محتوای سفارشی صفحات آرشیو ایجاد شود. همه این صفحات لزوماً ارزش یکسانی برای جستجو ندارند.
برای مثال، اگر صفحات برچسب سایت محتوای بسیار کمی داشته باشند یا تقریباً همان نوشتههای دستهبندیها را نمایش دهند، ممکن است ارزش مستقلی برای ایندکس شدن نداشته باشند. بهتر است هر نوع آرشیو از نظر نیاز کاربران، کیفیت محتوا و کاربرد آن بررسی شود و درباره ایندکس شدن یا عدم ایندکس آن تصمیم بگیرید.
۲. کنترل URLهای فیلتر و مرتبسازی ووکامرس
در فروشگاههای ووکامرسی، فیلتر محصولات، مرتبسازی قیمت، انتخاب ویژگیها و پارامترهای URL میتوانند آدرسهای متعددی تولید کنند. پیش از هر اقدامی باید مشخص کنید کدام ترکیبها ارزش جستجوی مستقلی دارند و کدام آدرسها فقط نسخههای متفاوتی از یک صفحه هستند.
برای URLهای غیرضروری میتوان با توجه به نحوه تولید و کاربرد آنها از روشهایی مانند اصلاح لینکسازی، Canonical، مدیریت پارامترها یا در موارد مناسب محدود کردن خزش استفاده کرد. نباید همه پارامترها را بدون بررسی مسدود کنید؛ زیرا ممکن است برخی از آنها برای نمایش و درک صحیح محتوای صفحه ضروری باشند.
۳. اصلاح نقشه سایت XML
نقشه سایت XML باید شامل URLهای اصلی و مهمی باشد که میخواهید گوگل آنها را کشف و بررسی کند. اگر آدرسهای ریدایرکتشده، صفحات حذفشده، صفحات دارای noindex یا URLهای غیرضروری در نقشه سایت قرار داشته باشند، کیفیت راهنمایی ارائهشده به خزنده کاهش پیدا میکند.
در سایت وردپرسی میتوانید با استفاده از امکانات افزونههای سئو، نقشه سایت را مدیریت کنید. پس از اصلاح ساختار URLها نیز بهتر است نقشه سایت را بررسی کنید تا آدرسهای اصلی و بهروز در آن قرار داشته باشند.
۴. بهبود لینکسازی داخلی
صفحات مهم نباید در ساختار سایت منزوی باشند. اگر یک مقاله، محصول یا صفحه خدمات از هیچ مسیر داخلی مناسبی قابل دسترسی نباشد، کشف آن برای خزنده دشوارتر میشود.
بهتر است صفحات مهم از دستهبندیهای مرتبط، مقالات مکمل و بخشهای اصلی سایت لینک دریافت کنند. همچنین باید از لینک دادن به URLهای دارای ریدایرکت یا آدرسهای غیرضروری خودداری شود تا مسیر خزش تا حد امکان مستقیم و روشن باشد.
۵. حذف یا اصلاح زنجیرههای ریدایرکت
اگر در طول زمان ساختار URL سایت تغییر کرده است، ممکن است چندین ریدایرکت روی هم ایجاد شده باشند. این زنجیرهها باید بررسی شوند و در صورت امکان، همه آدرسهای قدیمی مستقیماً به مقصد نهایی هدایت شوند.
۶. بررسی صفحات کمارزش و محتوای تکراری
صفحات کممحتوا، نسخههای تکراری، URLهای تولیدشده توسط افزونهها و صفحات بدون کاربرد مشخص باید بررسی شوند. در بعضی موارد ادغام محتوا، حذف صفحه، استفاده از ریدایرکت مناسب یا تنظیم Canonical میتواند راهکار بهتری از نگهداری تعداد زیادی URL مشابه باشد.
البته نباید صرفاً به دلیل کم بودن متن یک صفحه، آن را حذف کنید. بعضی صفحات کوتاه ممکن است برای کاربر کاربرد مشخصی داشته باشند. تصمیم نهایی باید با توجه به ارزش مستقل صفحه و هدف آن گرفته شود.
۷. افزایش سرعت و پایداری سرور
سرعت پاسخگویی سرور یکی از عوامل مؤثر بر ظرفیت خزش است. اگر سایت در زمان درخواستهای Googlebot با تأخیر زیاد یا خطاهای مکرر مواجه شود، ممکن است خزنده تعداد درخواستهای خود را کاهش دهد.
برای بهبود وضعیت فنی میتوانید مواردی مانند کیفیت هاست، نسخه PHP، تنظیمات پایگاه داده، کش سمت سرور، کش صفحات، بهینهسازی درخواستهای سنگین و وضعیت منابع میزبانی را بررسی کنید. استفاده از CDN نیز در بعضی معماریها میتواند به بهبود تحویل منابع کمک کند، اما بهتنهایی تضمینکننده افزایش Crawl Budget نیست.
آیا استفاده از robots.txt باعث افزایش Crawl Budget میشود؟
فایل robots.txt یکی از ابزارهای مدیریت دسترسی خزندهها است. از طریق این فایل میتوانید مشخص کنید خزندههای سازگار با استاندارد Robots Exclusion Protocol به کدام مسیرها دسترسی داشته باشند یا نداشته باشند.
اگر URLهای غیرضروری زیادی در سایت وجود داشته باشند، محدود کردن خزش آنها در شرایط مناسب میتواند به مدیریت بهتر منابع خزش کمک کند. با این حال، استفاده نادرست از robots.txt ممکن است باعث شود گوگل نتواند صفحات یا منابع مهم سایت را بررسی کند.
برای مثال، مسدود کردن فایلهای CSS و JavaScript ضروری ممکن است توانایی گوگل برای رندر و درک صحیح صفحه را مختل کند. همچنین باید توجه داشت که دستور Disallow در robots.txt مانع خزش است، نه یک روش قطعی برای حذف URL از ایندکس. اگر صفحهای با وجود مسدود بودن در robots.txt از طریق لینکهای دیگر شناخته شود، ممکن است همچنان بدون محتوای کامل در نتایج ظاهر شود.
اگر هدف شما جلوگیری از ایندکس شدن یک صفحه است، باید امکان خزش آن را برای گوگل فراهم کنید تا دستور noindex را ببیند. بنابراین robots.txt و noindex کاربردهای متفاوتی دارند و نباید بدون بررسی جایگزین یکدیگر شوند.
آیا میتوان Crawl Rate را در گوگل افزایش داد؟
مدیر سایت نمیتواند صرفاً با ثبت یک عدد در سرچ کنسول، گوگل را مجبور کند با سرعت بیشتری صفحات را خزش کند. Googlebot میزان درخواستها را بهصورت خودکار و با توجه به ظرفیت سرور و تقاضای خزش تنظیم میکند.
در گذشته ابزاری برای محدود کردن نرخ خزش در Search Console وجود داشت، اما ابزار عمومی Crawl Rate Limiter در سال ۲۰۲۴ کنار گذاشته شد. در حال حاضر، اگر با خزش بیش از حد و فشار بر سرور مواجه هستید، باید علت درخواستها را شناسایی و از روشهای مناسب برای مدیریت آنها استفاده کنید.
برای بهبود شرایط خزش، اقدامات زیر میتوانند مفید باشند:
- رفع خطاهای سرور و افزایش پایداری میزبانی
- کاهش زمان پاسخگویی و بهینهسازی منابع سرور
- حذف مسیرهای تکراری و غیرضروری از ساختار قابل خزش سایت
- بهبود لینکسازی داخلی و دسترسی به صفحات مهم
- بهروزرسانی نقشه سایت و معرفی URLهای اصلی
- بررسی منظم Crawl Stats و لاگ سرور برای شناسایی مشکلات
با این حال، افزایش سرعت خزش نباید هدف مستقل سئو باشد. هدف اصلی، فراهم کردن شرایطی است که گوگل بتواند صفحات ارزشمند سایت را در زمان مناسب کشف و بررسی کند، بدون اینکه منابع سرور تحت فشار قرار بگیرند.
اشتباهات رایج در مدیریت Crawl Budget
برخی از مدیران سایت هنگام مواجهه با مشکلات خزش، اقداماتی انجام میدهند که نهتنها مشکل را حل نمیکند، بلکه ممکن است دسترسی گوگل به صفحات مهم را نیز محدود کند. مهمترین اشتباهات عبارتاند از:
- مسدود کردن گسترده URLها در robots.txt: بستن مسیرهای مهم یا منابع موردنیاز رندر صفحه میتواند مشکلساز شود.
- حذف همه صفحات کمارزش بدون بررسی: هر صفحهای که ترافیک کمی دارد الزاماً بیارزش نیست؛ ممکن است برای کاربران یا بخش دیگری از سایت کاربرد داشته باشد.
- استفاده از noindex برای کنترل Crawl Budget: صفحه دارای noindex همچنان باید خزش شود تا گوگل این دستور را ببیند؛ بنابراین noindex راهکار مستقیم کاهش خزش نیست.
- تصور اینکه افزایش سرعت سرور همیشه بودجه خزش را بالا میبرد: ظرفیت فنی تنها یکی از دو مؤلفه اصلی Crawl Budget است و تقاضای خزش نیز اهمیت دارد.
- تلاش برای افزایش تعداد درخواستهای Googlebot: بالا بودن تعداد درخواستها بهتنهایی نشانه موفقیت سئو نیست.
- نادیده گرفتن وضعیت صفحات مهم: باید بررسی شود که URLهای ارزشمند واقعاً کشف و خزش میشوند، نه اینکه صرفاً تعداد کل درخواستها افزایش پیدا کند.
چکلیست عملی برای بررسی وضعیت خزش سایت
اگر قصد دارید وضعیت Crawl Budget و Crawl Rate وبسایت خود را ارزیابی کنید، میتوانید از چکلیست زیر بهعنوان نقطه شروع استفاده کنید. این بررسی بهخصوص برای سایتهای بزرگ، فروشگاههای اینترنتی و وبسایتهایی که صفحات زیادی تولید میکنند مفید است.
- گزارش Crawl Stats در سرچ کنسول را بررسی کنید.
- میانگین زمان پاسخ سرور و روند تغییر آن را زیر نظر بگیرید.
- درصد پاسخهای ۲۰۰، ۳۰۱، ۴۰۴ و ۵xx را بررسی کنید.
- URLهای تکراری و دارای پارامترهای غیرضروری را شناسایی کنید.
- صفحات فیلتر و مرتبسازی فروشگاه را از نظر ارزش جستجو ارزیابی کنید.
- مطمئن شوید نقشه سایت فقط URLهای اصلی و مناسب را معرفی میکند.
- لینکهای داخلی به صفحات مهم را بررسی کنید.
- زنجیرههای ریدایرکت و لینکهای شکسته را اصلاح کنید.
- لاگ سرور را برای شناسایی URLهای پرتکرار و درخواستهای Googlebot تحلیل کنید.
- وضعیت ایندکس صفحات مهم را با URL Inspection بررسی کنید.
- اطمینان حاصل کنید که منابع ضروری رندر صفحات در robots.txt مسدود نشدهاند.
جمعبندی؛ مدیریت خزش باید بر اساس نیاز واقعی سایت انجام شود
Crawl Rate و Crawl Budget دو مفهوم مرتبط اما متفاوت در سئو تکنیکال هستند. Crawl Rate به سرعت و میزان درخواستهای خزنده مربوط میشود و Crawl Budget مجموعه URLهایی را در بر میگیرد که گوگل توانایی و تمایل دارد آنها را خزش کند. ظرفیت خزش سرور و تقاضای گوگل برای بررسی صفحات، دو مؤلفه اصلی تعیین بودجه خزش هستند.
مدیریت این دو مفهوم برای سایتهای بزرگ، فروشگاههای اینترنتی و وبسایتهای پرتغییر اهمیت بیشتری دارد. با اصلاح URLهای تکراری، کنترل صفحات فیلتر، بهبود لینکسازی داخلی، مدیریت نقشه سایت و افزایش پایداری سرور میتوان شرایط مناسبتری برای خزش صفحات ارزشمند فراهم کرد.
در پرشیا وب، سئو تکنیکال تنها به بررسی رتبه کلمات کلیدی محدود نمیشود. ساختار URLها، وضعیت ایندکس، عملکرد سرور، لینکسازی داخلی و نحوه دسترسی خزندهها به صفحات نیز باید در کنار یکدیگر تحلیل شوند. اگر وبسایت شما با مشکلات خزش، ایندکس نشدن صفحات مهم یا تولید تعداد زیادی URL غیرضروری مواجه است، بررسی فنی سایت میتواند به شناسایی علت و انتخاب راهکار مناسب کمک کند.
سؤالات متداول درباره Crawl Budget و Crawl Rate
آیا Crawl Budget یک عدد ثابت برای هر سایت است؟
خیر. بودجه خزش عددی ثابت و قابل تنظیم توسط مدیر سایت نیست. این مفهوم بر اساس ظرفیت خزش و تقاضای گوگل شکل میگیرد و با تغییر وضعیت سرور، ساختار URLها، کیفیت و میزان تغییر محتوا ممکن است دستخوش تغییر شود.
آیا افزایش Crawl Rate باعث افزایش رتبه سایت میشود؟
خیر. افزایش نرخ خزش بهتنهایی یک عامل مستقیم رتبهبندی نیست. خزش مناسب میتواند به کشف و بررسی صفحات کمک کند، اما رتبه صفحه به عوامل متعدد دیگری مانند کیفیت محتوا، ارتباط با جستجوی کاربر و سایر سیستمهای رتبهبندی گوگل بستگی دارد.
آیا سایتهای وردپرسی کوچک هم باید نگران Crawl Budget باشند؟
در بیشتر موارد خیر. اگر سایت تعداد محدودی صفحه دارد و صفحات جدید آن در زمان معقول توسط گوگل کشف میشوند، معمولاً نیازی به مدیریت پیچیده بودجه خزش نیست. بهتر است ابتدا روی کیفیت محتوا، ساختار لینکسازی داخلی، نقشه سایت و رفع مشکلات ایندکس تمرکز کنید.
تفاوت Crawl Budget با Index Budget چیست؟
Crawl Budget یک مفهوم شناختهشده در مستندات گوگل برای توصیف URLهایی است که خزنده توانایی و تمایل به بررسی آنها دارد. اما Index Budget اصطلاحی نیست که بتوان آن را بهعنوان یک سهمیه ثابت و رسمی برای تعداد صفحات قابل ایندکس در نظر گرفت. خزش شدن یک صفحه نیز به معنای تضمین ایندکس شدن آن نیست.
آیا استفاده از تگ Canonical باعث کاهش Crawl Budget میشود؟
Canonical به گوگل کمک میکند نسخه ترجیحی یک مجموعه URL مشابه را شناسایی کند، اما دستور مستقیم برای جلوگیری از خزش URLهای دیگر نیست. اگر هدف کاهش خزش آدرسهای غیرضروری باشد، باید ساختار تولید URL، لینکسازی و در صورت لزوم سیاستهای دسترسی را نیز بررسی کنید.
چگونه متوجه شویم Googlebot صفحات مهم سایت را خزش نمیکند؟
برای این کار میتوانید گزارش Crawl Stats را بررسی کنید، وضعیت URLهای مهم را در URL Inspection ببینید و در صورت نیاز لاگ سرور را تحلیل کنید. اگر صفحهای در لاگ درخواست نشده باشد، باید مسیر کشف آن، لینکهای داخلی، نقشه سایت و محدودیتهای دسترسی را بررسی کنید.
آیا سرعت هاست بر Crawl Budget تأثیر دارد؟
بله. سرعت پاسخگویی و پایداری سرور بر ظرفیت خزش تأثیر دارند. اگر سرور کند باشد یا خطاهای زیادی برگرداند، گوگل ممکن است نرخ درخواستهای خود را کاهش دهد. البته سرعت بالای هاست بهتنهایی باعث افزایش نامحدود Crawl Budget نمیشود؛ تقاضای خزش و وضعیت URLهای سایت نیز اهمیت دارند.
منابع و مطالعه بیشتر
- Google Crawling Infrastructure – راهنمای رسمی بهینهسازی Crawl Budget
- Google Search Console Help – گزارش Crawl Stats
- Google Search Central – راهنمای عیبیابی مشکلات خزش
- Google Search Central – راهنمای مدیریت دسترسی خزندهها با robots.txt
- Google Search Central – توضیحات فنی درباره خزش منابع و فایلهای سایت
“`
