شاید برای شما هم پیش آمده باشد که یک مقاله یا صفحه جدید در سایت منتشر کنید، اما چند ساعت یا حتی چند روز بعد، وقتی عنوان آن را در گوگل جستجو میکنید، اثری از آن نبینید. در چنین شرایطی معمولاً اولین سؤال این است که چرا صفحه من در گوگل ایندکس نشده است؟
برای پاسخ دقیق به این سؤال، ابتدا باید بدانیم ایندکس سایت چیست، گوگل چگونه صفحات را پیدا و بررسی میکند و چه تفاوتی میان Crawl، Indexing و Ranking وجود دارد. بسیاری از مشکلاتی که مدیران سایت با عنوان «مشکل ایندکس» میشناسند، در واقع به کشف URL، خزش، Canonical، محتوای تکراری، وضعیت سرور یا حتی رتبهبندی مربوط میشوند.
ایندکس شدن یک صفحه به معنی رتبه گرفتن آن نیست. گوگل ابتدا باید URL را کشف کند، بتواند آن را دریافت و پردازش کند و سپس تصمیم بگیرد که اطلاعات صفحه را در Index خود نگهداری کند. بعد از آن، صفحه میتواند برای جستجوهای مختلف وارد فرایند رتبهبندی شود.
در این راهنمای آموزشی از پرشیا وب، هدف فقط ارائه یک تعریف ساده از ایندکس نیست. در ادامه یاد میگیرید چگونه وضعیت ایندکس یک URL را بررسی کنید، علت ایندکس نشدن صفحات را پیدا کنید و با استفاده از Google Search Console، Sitemap، لینک داخلی و اصلاح مشکلات فنی، شرایط مناسبتری برای ایندکس صفحات ایجاد کنید.
ایندکس سایت چیست؟
ایندکس (Index) را میتوان مجموعهای از اطلاعات صفحات وب دانست که گوگل پس از کشف و پردازش آنها برای استفاده در سیستم جستجوی خود نگهداری میکند.
وقتی گوگل صفحهای را Crawl میکند، صرفاً آدرس آن را ثبت نمیکند. محتوای صفحه، متن، لینکها، تصاویر، ساختار و برخی سیگنالهای فنی آن پردازش میشوند. سپس گوگل با توجه به شرایط مختلف تصمیم میگیرد که صفحه یا نسخهای از آن در Index قرار بگیرد یا خیر.
بنابراین وقتی میگوییم:
«این صفحه در گوگل ایندکس شده است»
منظور این است که گوگل صفحه را در سیستم Index خود دارد و صفحه از نظر ایندکس شدن در وضعیت مناسبی قرار گرفته است؛ اما این موضوع بهتنهایی تضمین نمیکند که صفحه برای هر عبارت جستجو نمایش داده شود یا رتبه خوبی داشته باشد.
در واقع ممکن است یک صفحه:
- Crawl شده باشد؛
- در Index قرار گرفته باشد؛
- اما برای کلمه کلیدی هدف در رتبههای پایین قرار داشته باشد.
به همین دلیل، ایندکس سایت، Crawl و Ranking سه مفهوم متفاوت هستند.
گوگل چگونه صفحات سایت را پیدا و ایندکس میکند؟
برای درک بهتر ایندکس سایت، بهتر است مسیر یک URL را از لحظه انتشار تا حضور احتمالی در نتایج جستجو دنبال کنیم.
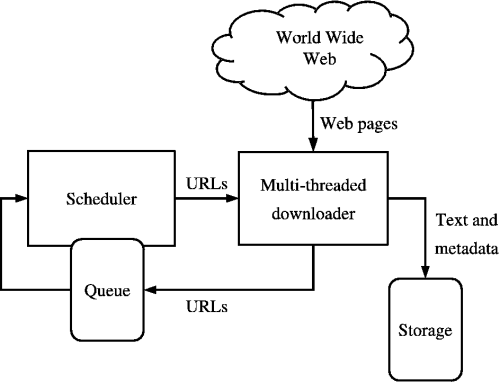
کشف URL → Crawl → پردازش و در صورت نیاز Rendering → Indexing → Ranking → نمایش در نتایج جستجو
گوگل این فرایند را در سطح کلان در قالب Crawling، Indexing و Serving Search Results توضیح میدهد. بنابراین ایندکس فقط یک مرحله از مسیر طولانیتری است که یک صفحه برای حضور در جستجو طی میکند.
۱. کشف URL
گوگل ابتدا باید از وجود URL مطلع شود. این اتفاق میتواند از طریق لینکهای داخلی، لینکهای خارجی، نقشه سایت یا URLهایی که قبلاً شناخته شدهاند رخ دهد.
به همین دلیل صفحهای که هیچ لینک داخلی ندارد و در Sitemap نیز قرار نگرفته است، مسیرهای کمتری برای کشف شدن خواهد داشت.
در این مرحله، ساختار سایت و لینکسازی داخلی اهمیت زیادی پیدا میکند. برای مثال، اگر مقاله جدیدی منتشر کردهاید، لینک دادن از چند صفحه مرتبط و قابل دسترس میتواند مسیر مناسبی برای کشف URL ایجاد کند. در این زمینه میتوانید راهنمای لینکسازی داخلی را نیز مطالعه کنید.
۲. Crawl یا خزش
پس از کشف URL، Googlebot تلاش میکند صفحه را دریافت و بررسی کند. در این مرحله مواردی مانند دسترسی به سرور، وضعیت HTTP، robots.txt، خطاهای شبکه و شرایط فنی صفحه اهمیت پیدا میکنند.
برای یک صفحه معمولی که قرار است در نتایج جستجو حضور داشته باشد، پاسخ موفق HTTP و دسترسی مناسب Googlebot از الزامات پایه محسوب میشود. با این حال، رعایت این الزامات به معنی تضمین ایندکس شدن صفحه نیست.
۳. Rendering یا پردازش صفحه
در سایتهایی که بخش مهمی از محتوا با JavaScript تولید میشود، دریافت HTML اولیه ممکن است برای درک کامل صفحه کافی نباشد. در چنین شرایطی گوگل میتواند صفحه را Render کند تا محتوای تولیدشده توسط JavaScript را نیز پردازش کند.
اگر محتوای اصلی صفحه فقط بعد از اجرای یک اسکریپت خاص، کلیک کاربر یا تعامل دیگری ظاهر شود، باید پیادهسازی آن بررسی شود. URL Inspection و ابزارهای آزمایش گوگل میتوانند برای بررسی نسخه Render شده صفحه مفید باشند.
۴. Indexing
پس از پردازش صفحه، گوگل باید تصمیم بگیرد که چه اطلاعاتی را در Index نگهداری کند. در این مرحله عواملی مانند محتوای صفحه، نسخههای مشابه، Canonical، قابلیت دسترسی، کیفیت و ارزش مستقل صفحه میتوانند اهمیت داشته باشند.
اگر چند URL محتوای بسیار مشابهی داشته باشند، گوگل میتواند یکی از آنها را بهعنوان نسخه نماینده انتخاب کند و URLهای دیگر را در Index اصلی خود قرار ندهد. همچنین Canonical اعلامشده توسط سایت همیشه بهصورت قطعی توسط گوگل انتخاب نمیشود و گوگل میتواند Canonical دیگری را انتخاب کند.
۵. Ranking یا رتبهبندی
بعد از اینکه صفحه در Index قرار گرفت، تازه موضوع رتبهبندی مطرح میشود. صفحه ممکن است برای یک Query در رتبه مناسبی قرار بگیرد، برای عبارت دیگری رتبه بسیار پایینتری داشته باشد یا برای یک جستجوی خاص اصلاً نمایش داده نشود.
بنابراین:
Index شدن ≠ رتبه گرفتن
تفاوت Crawl، Index و Ranking چیست؟
اگر بخواهیم این سه مفهوم را بسیار ساده توضیح دهیم:
- Crawl: گوگل URL را پیدا کرده و تلاش کرده است محتوای آن را دریافت و بررسی کند.
- Index: اطلاعات صفحه پس از پردازش در سیستم Index گوگل قرار گرفته است.
- Ranking: صفحه در پاسخ به یک Query مشخص در جایگاه خاصی از نتایج جستجو قرار گرفته است.
برای مثال ممکن است مقالهای کاملاً Crawl شده باشد و در Index نیز قرار گرفته باشد، اما برای عبارت هدف خود در صفحه ششم نتایج قرار داشته باشد. در این حالت مشکل اصلی ایندکس سایت نیست؛ باید محتوا، هدف جستجو، رقبا، اعتبار صفحه و سایر عوامل رتبهبندی بررسی شوند.
آیا ایندکس شدن صفحه یعنی صفحه حتماً در گوگل دیده میشود؟
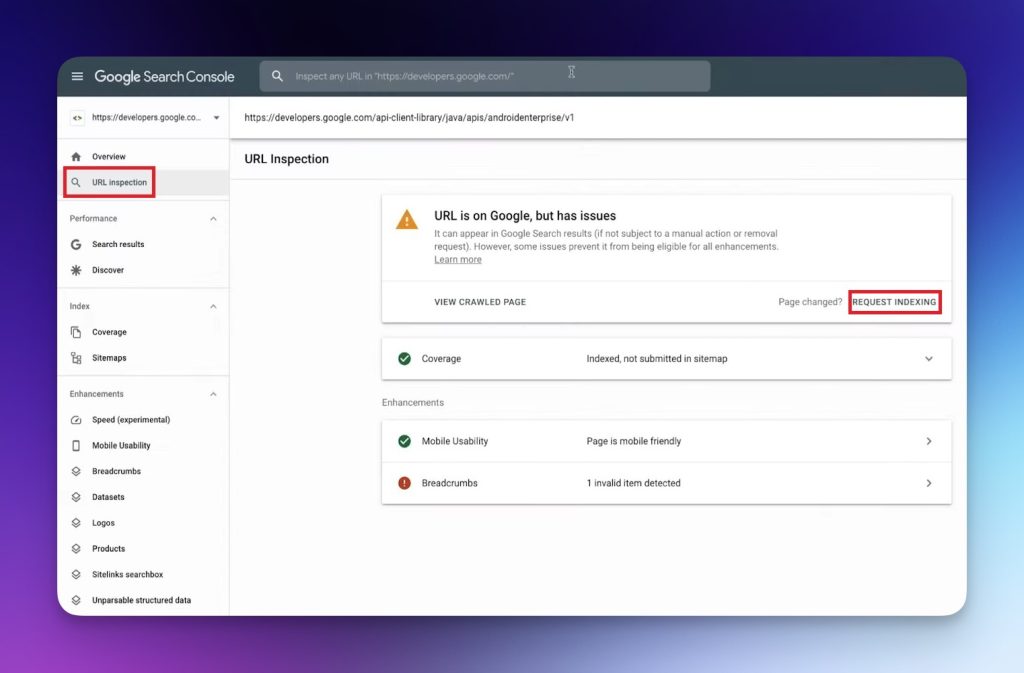
خیر. حتی اگر Search Console وضعیت «URL is on Google» را نشان دهد، این عبارت به معنی نمایش صفحه برای هر جستجوی ممکن نیست. ابزار URL Inspection نیز تصریح میکند که قرار گرفتن URL در Google تضمین نمیکند صفحه برای همه Queryها در نتایج نمایش داده شود.
بنابراین هنگام بررسی یک صفحه، سه سؤال متفاوت بپرسید:
- آیا گوگل URL را پیدا کرده است؟
- آیا URL ایندکس شده است؟
- آیا صفحه برای Query موردنظر رتبه و Impression دریافت میکند؟
این تفکیک از بسیاری از تحلیلهای اشتباه درباره ایندکس سایت جلوگیری میکند.
چگونه بفهمیم یک صفحه در گوگل ایندکس شده است؟
برای بررسی دقیق یک URL، بهترین ابزار Google Search Console و بخش URL Inspection است. URL را در نوار بالای Search Console وارد کنید تا وضعیت آن بررسی شود.
URL Inspection اطلاعاتی مانند وضعیت Index، آخرین Crawl، امکان Crawl، امکان Index، Canonical اعلامشده و Canonical انتخابشده توسط گوگل را در اختیار شما قرار میدهد. همچنین میتوانید نسخه Live URL را آزمایش کرده و در صورت نیاز نمای Render شده صفحه را ببینید.
جستجوی URL با عملگر site: نیز میتواند برای یک بررسی سریع مفید باشد؛ اما برای تشخیص دقیق وضعیت یک URL، خود URL Inspection ابزار قابلاعتمادتری است.
site:example.com/page/اگر URL در جستجوی site: دیده نشد، فوراً نتیجه نگیرید که حتماً ایندکس نشده است؛ وضعیت دقیق را از Search Console بررسی کنید.
چرا صفحه من در گوگل ایندکس نشده است؟
ایندکس نشدن یک صفحه علت واحدی ندارد. مهمترین نکته این است که ابتدا وضعیت URL را مشخص کنید و بعد سراغ علت بروید.
۱. صفحه هنوز کشف نشده است
ممکن است گوگل هنوز URL را پیدا نکرده باشد. این وضعیت برای سایتهای جدید، صفحات بدون لینک داخلی یا URLهایی که در Sitemap معرفی نشدهاند، محتملتر است.
۲. صفحه با robots.txt مسدود شده است
فایل robots.txt برای کنترل دسترسی خزندهها به مسیرهای سایت استفاده میشود. اگر مسیر یک صفحه مهم در robots.txt مسدود شده باشد، Googlebot نمیتواند محتوای آن را به شکل عادی Crawl کند.
User-agent: *
Disallow: /private/
نکته بسیار مهم این است که robots.txt ابزار مناسبی برای حذف قطعی یک URL از نتایج گوگل نیست. اگر هدف شما جلوگیری از Index شدن صفحه است، باید از روش مناسب مانند noindex استفاده کنید و در عین حال اجازه دهید گوگل بتواند صفحه را Crawl کند تا دستور noindex را ببیند.
۳. صفحه Noindex دارد
اگر صفحه دارای دستور زیر باشد، به موتور جستجو اعلام میکند که صفحه نباید در نتایج جستجو ایندکس شود:
<meta name="robots" content="noindex">اگر این دستور بهصورت عمدی قرار گرفته باشد، مشکلی وجود ندارد. اما اگر صفحهای که باید در گوگل نمایش داده شود بهاشتباه Noindex شده باشد، باید تنظیمات CMS، قالب یا افزونه SEO بررسی شود.
۴. Canonical صفحه دیگری است
فرض کنید صفحه A دارای Canonical زیر باشد:
<link rel="canonical" href="https://example.com/page-b/">در این شرایط سایت به گوگل اعلام میکند که صفحه B نسخه ترجیحی است. اگر چنین تنظیمی اشتباه باشد، ممکن است صفحهای که قصد ایندکس کردن آن را دارید، در Index اصلی قرار نگیرد.
البته باید توجه داشت که Canonical یک دستور مطلق برای گوگل نیست و گوگل میتواند با توجه به شرایط، Canonical دیگری را انتخاب کند.
۵. صفحه 404 یا دارای خطای سرور است
صفحهای که 404، 500، 502 یا 503 برمیگرداند، شرایط یک صفحه سالم را ندارد. برای ایندکس شدن، صفحه باید بتواند با وضعیت موفق HTTP در اختیار Googlebot قرار بگیرد.
بنابراین اگر صفحات مهم سایت با خطاهای سرور مواجه هستند، قبل از هر اقدامی برای Request Indexing، مشکل زیرساخت را برطرف کنید. Google نیز HTTP 200 را بهعنوان یکی از الزامات فنی پایه برای صفحهای که قرار است ایندکس شود معرفی میکند.
۶. صفحه Soft 404 است
گاهی URL از نظر فنی پاسخ 200 میدهد، اما محتوای آن عملاً نشان میدهد که صفحه وجود ندارد یا اطلاعات مفیدی ارائه نمیکند. این وضعیت میتواند در برخی صفحات حذفشده، دستهبندیهای خالی یا صفحات بدون نتیجه دیده شود.
۷. صفحه Duplicate است
ممکن است صفحه هیچ خطای فنی نداشته باشد، اما محتوای آن تفاوت معناداری با یک URL دیگر نداشته باشد. در چنین شرایطی گوگل میتواند یک URL را بهعنوان نسخه نماینده انتخاب کند و نسخههای دیگر را در Index قرار ندهد.
۸. صفحه ارزش مستقل کافی ندارد
گاهی مشکل فنی مشخصی وجود ندارد و صفحه توسط گوگل نیز Crawl شده است، اما در نهایت ایندکس نمیشود. در چنین شرایطی باید بررسی کنید آیا صفحه واقعاً اطلاعات مستقل و مفیدی ارائه میدهد یا صرفاً نسخهای مشابه از صفحات دیگر سایت یا وب است.
این وضعیت همان جایی است که ارسال مکرر Request Indexing معمولاً کمکی نمیکند. اگر مسئله به ارزش، تمایز یا ساختار محتوا مربوط باشد، باید خود صفحه یا معماری محتوا اصلاح شود.
«Crawled – currently not indexed» یعنی چه؟
اگر در Search Console با عبارت Crawled – currently not indexed مواجه شدید، مفهوم اصلی آن این است که گوگل URL را Crawl کرده، اما در حال حاضر آن را در Index قرار نداده است.
این وضعیت بهتنهایی به معنی وجود یک خطای فنی در صفحه نیست. بنابراین نباید بلافاصله چندین بار Request Indexing ارسال کنید.
در چنین شرایطی این موارد را بررسی کنید:
- آیا محتوای صفحه واقعاً ارزش مستقل دارد؟
- آیا صفحه با URL دیگری بسیار مشابه است؟
- آیا Canonical صحیح است؟
- آیا محتوای اصلی در نسخه Render شده قابل مشاهده است؟
- آیا صفحه از صفحات مرتبط سایت لینک داخلی دریافت کرده است؟
- آیا صفحه صرفاً یکی از دهها URL مشابه با تغییرات جزئی است؟
در واقع برای این وضعیت باید بیشتر به کیفیت، تمایز و جایگاه صفحه در ساختار سایت نگاه کرد تا صرفاً به تعداد دفعات ارسال درخواست ایندکس.
«Discovered – currently not indexed» یعنی چه؟
این وضعیت با مورد قبلی متفاوت است. Discovered – currently not indexed یعنی گوگل از وجود URL مطلع شده، اما هنوز آن را Crawl نکرده است.
اگر این وضعیت فقط برای چند URL جدید دیده شود، الزاماً نشانه مشکل جدی نیست. اما اگر تعداد زیادی از صفحات مهم سایت برای مدت طولانی در این وضعیت باقی بمانند، باید ساختار سایت، لینکهای داخلی، Sitemap، وضعیت سرور و تعداد URLهای غیرضروری بررسی شوند.
در سایتهای بزرگ، وجود حجم بالایی از URLهای کمارزش، فیلترها، پارامترها و صفحات مشابه میتواند بررسی و مدیریت خزش را پیچیدهتر کند. بنابراین در چنین سایتهایی باید به وضعیت کلی Crawl نیز نگاه کرد، نه فقط یک URL منفرد.
چگونه از Google Search Console درخواست ایندکس کنیم؟
اگر صفحه از نظر فنی و محتوایی آماده است، میتوانید از URL Inspection برای درخواست Crawl و بررسی مجدد آن استفاده کنید.
مسیر کلی به این شکل است:
Google Search Console → URL Inspection → وارد کردن URL → Request Indexing
اما باید یک نکته مهم را در نظر داشته باشید: Request Indexing فرمان ایندکس نیست. این قابلیت درخواست بررسی URL را به گوگل ارسال میکند و ایندکس شدن صفحه را تضمین نمیکند. گوگل حتی برای این درخواستها محدودیت روزانه دارد و برای تعداد زیادی URL، استفاده از Sitemap را روش مناسبتری میداند.
بنابراین اگر صفحهای Noindex است، Canonical اشتباه دارد، Duplicate است یا مشکل Crawl دارد، چند بار کلیک کردن روی Request Indexing مشکل اصلی را حل نمیکند.
Sitemap چه نقشی در ایندکس سایت دارد؟
XML Sitemap فهرستی از URLهایی است که میخواهید گوگل از وجود آنها مطلع باشد. Sitemap به کشف URLها کمک میکند، اما به هیچ عنوان دستور ایندکس نیست.
یعنی اگر URL زیر را در Sitemap قرار دهید، نمیتوانید نتیجه بگیرید که گوگل حتماً آن را ایندکس خواهد کرد.
Sitemap = معرفی URL، نه تضمین Indexing
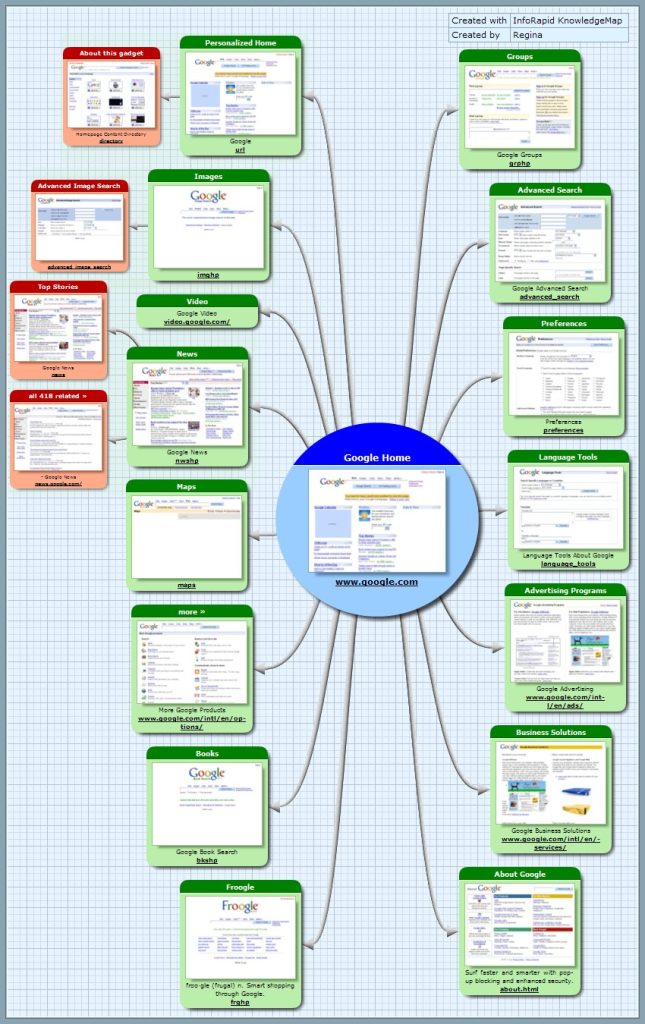
برای سایتهای بزرگ یا سایتهایی که URLهای زیادی دارند، Sitemap اهمیت بیشتری پیدا میکند. با این حال، Sitemap باید بهصورت منطقی مدیریت شود و بهتر است شامل URLهای معتبر، قابل دسترسی و مهمی باشد که واقعاً قصد دارید در Search حضور داشته باشند.
چه URLهایی را در Sitemap قرار دهیم؟
- صفحات اصلی و مهم سایت
- مقالات و صفحات خدماتی قابل ایندکس
- URLهای Canonical و نسخه اصلی محتوا
- صفحات سالم و قابل دسترسی
در مقابل، معمولاً نباید URLهای 404، Redirect شده، Noindex و نسخههای تکراری را بهعنوان URLهای اصلی در Sitemap قرار دهید.
Lastmod در Sitemap چیست؟
در Sitemap میتوان تاریخ آخرین تغییر معنادار یک URL را با تگ <lastmod> مشخص کرد:
<url>
    <loc>https://example.com/article/</loc>
    <lastmod>2026-09-01</lastmod>
</url>
این تاریخ باید تا حد امکان بازتابدهنده تغییر واقعی و معنادار صفحه باشد. تغییر مصنوعی تاریخ تمام URLها بدون تغییر واقعی محتوا، استفاده مناسبی از Lastmod نیست.
لینک داخلی چه تأثیری بر ایندکس سایت دارد؟
لینک داخلی یکی از مهمترین مسیرهای کشف صفحات در یک سایت است. وقتی مقاله جدیدی منتشر میکنید، اگر هیچ صفحه دیگری به آن لینک ندهد، مسیرهای دسترسی Googlebot به آن URL محدودتر میشود.
برای مثال میتوانید از یک مقاله قدیمی و مرتبط به مقاله جدید لینک دهید:
مقاله قدیمی مرتبط → مقاله جدید
یا از صفحه دستهبندی به مقاله لینک کنید:
دستهبندی → مقاله
این ساختار علاوه بر کمک به کشف URL، ارتباط میان صفحات و معماری موضوعی سایت را نیز بهتر مشخص میکند.
آیا Sitemap جای لینک داخلی را میگیرد؟
خیر. Sitemap و لینک داخلی نقش یکسانی ندارند. Sitemap URLها را به گوگل معرفی میکند، در حالی که لینک داخلی علاوه بر ایجاد مسیر کشف، ارتباط صفحات با یکدیگر و ساختار سایت را نیز نشان میدهد.
بهترین حالت برای یک سایت حرفهای، استفاده همزمان از:
Sitemap + لینک داخلی + معماری منطقی سایت
چگونه سرعت ایندکس صفحات سایت را افزایش دهیم؟
هیچ تکنیک جادویی برای ایندکس فوری تمام صفحات وجود ندارد. حتی رعایت الزامات فنی پایه نیز تضمین نمیکند که همه URLها در Index قرار بگیرند.
اما میتوان شرایط سایت را برای کشف، Crawl و پردازش بهتر صفحات بهبود داد.
Sitemap سالم داشته باشید
URLهای مهم را در Sitemap قرار دهید و مطمئن شوید Sitemap بهدرستی در Search Console معرفی شده است.
لینک داخلی هدفمند ایجاد کنید
از صفحات مرتبط و قابلاعتماد سایت به URLهای جدید و مهم لینک بدهید.
URLهای غیرضروری تولید نکنید
فیلترها، پارامترها، صفحات جستجوی داخلی و URLهای مشابه میتوانند تعداد URLهای سایت را بهشدت افزایش دهند. در سایتهای بزرگ باید مراقب بود که بخش زیادی از منابع خزش صرف URLهایی نشود که ارزش واقعی برای Search ندارند.
خطاهای Crawl را برطرف کنید
خطاهای DNS، Timeout، خطاهای 5xx و مشکلات دسترسی Googlebot باید جدی گرفته شوند؛ بهخصوص اگر تعداد زیادی از صفحات سایت را تحت تأثیر قرار داده باشند.
Canonical را بررسی کنید
برای صفحات مشابه، نسخه اصلی را بهدرستی مشخص کنید و مراقب باشید افزونه یا سیستم مدیریت محتوا Canonical اشتباهی ایجاد نکرده باشد.
Noindex ناخواسته را حذف کنید
تنظیمات افزونههای SEO، CMS، قالب و Header صفحه را بررسی کنید.
محتوای تکراری و کمارزش را مدیریت کنید
اگر دهها صفحه تقریباً یک محتوای مشابه دارند، صرفاً افزایش تعداد URLها به معنی افزایش ارزش سایت نیست. صفحات مشابه را ادغام، بهینه یا در صورت نیاز از Index خارج کنید.
صفحات مهم را در ساختار سایت رها نکنید
صفحات مهم باید از مسیرهای منطقی سایت قابل دسترسی باشند. صفحهای که در ساختار سایت هیچ ارتباط مشخصی ندارد، برای کاربران و موتور جستجو نیز شرایط مطلوبی ندارد.
آیا سرعت سایت روی ایندکس شدن تأثیر دارد؟
سرعت و پایداری سرور میتواند روی فرایند Crawl تأثیر بگذارد، اما نباید رابطه را به شکل سادهای مانند «سایت سریع = ایندکس فوری» در نظر گرفت.
اگر سرور مرتباً Timeout یا خطای 5xx ایجاد میکند، مشکل فنی جدی وجود دارد و باید برطرف شود. اما صرفاً کمی کندتر بودن یک صفحه نسبت به صفحه دیگر، دلیل کافی برای نسبت دادن مشکل Indexing به سرعت نیست.
برای تشخیص مشکل واقعی، بهتر است وضعیت URL و دادههای Search Console را بررسی کنید.
آیا Crawl Budget باعث افزایش ایندکس سایت میشود؟
نه لزوماً. Crawl و Index دو مرحله متفاوت هستند.
ممکن است گوگل صفحهای را Crawl کند اما آن را در Index قرار ندهد. بنابراین اگر تعداد زیادی URL با وضعیت Crawled – currently not indexed دارید، صرفاً افزایش Crawl بهعنوان راهحل قطعی منطقی نیست.
Crawl Budget بیشتر در سایتهای بسیار بزرگ اهمیت پیدا میکند؛ جایی که تعداد بسیار زیادی URL، پارامتر، فیلتر یا نسخه مشابه وجود دارد.
در چنین پروژههایی مدیریت Crawl Budget یعنی تلاش برای استفاده کارآمد از منابع خزش، نه اینکه صرفاً تعداد Crawlها را افزایش دهیم.
برای مثال، تصور کنید یک فروشگاه ۱۰ هزار محصول دارد اما بهدلیل فیلترهای متعدد میلیونها URL قابل تولید است. در چنین شرایطی باید بررسی شود Googlebot بیشتر وقت خود را صرف چه URLهایی میکند و آیا URLهای کمارزش بخش زیادی از مسیر خزش را اشغال کردهاند یا خیر.
آیا JavaScript میتواند مانع ایندکس شدن محتوا شود؟
در برخی پیادهسازیها، بله. اگر محتوای اصلی صفحه فقط پس از اجرای JavaScript تولید شود و گوگل نتواند آن را بهدرستی دریافت یا Render کند، درک و پردازش صفحه میتواند با مشکل مواجه شود.
این موضوع مخصوصاً زمانی مهم است که موارد اصلی صفحه مانند متن مقاله، عنوان محصول، لینکهای مهم یا اطلاعات کلیدی فقط بعد از تعامل کاربر تولید شوند.
در چنین شرایطی بهتر است URL را با URL Inspection بررسی کنید و نسخه Render شده را ببینید. Google Search نیز برای بررسی مشکلات JavaScript و نحوه مشاهده محتوای صفحه توسط Googlebot، استفاده از ابزارهای تست و URL Inspection را توصیه میکند.
آیا Lazy Loading میتواند باعث ایندکس نشدن محتوا شود؟
اگر Lazy Loading بهدرستی پیادهسازی نشده باشد، ممکن است بخشی از محتوای مهم برای Googlebot قابل مشاهده نباشد.
محتوای مهم نباید صرفاً بعد از کلیک، اسکرول یا تعامل خاص کاربر بارگذاری شود. گوگل توصیه میکند محتوای Lazy-loaded در زمان مناسب و بدون نیاز به تعامل کاربر در دسترس قرار گیرد.
بنابراین اگر صفحهای از JavaScript یا Lazy Loading استفاده زیادی میکند، نسخه Render شده آن را در URL Inspection بررسی کنید.
آیا انتشار منظم مقاله باعث افزایش سرعت ایندکس میشود؟
انتشار منظم محتوا به خودی خود تضمین نمیکند که صفحات جدید سریعتر ایندکس شوند.
اگر روزانه تعداد زیادی صفحه مشابه و کمارزش تولید کنید، تعداد URLهایی را که باید مدیریت شوند افزایش دادهاید. در مقابل، تعداد کمتری صفحه با محتوای دقیق، کاربردی، متمایز و مرتبط میتواند ارزش بیشتری برای سایت ایجاد کند.
بنابراین در استراتژی محتوا، سؤال اصلی نباید «چند مقاله منتشر کنیم تا سریعتر ایندکس شویم؟» باشد؛ بلکه باید پرسید:
«آیا هر صفحهای که منتشر میکنیم واقعاً ارزش حضور مستقل در نتایج جستجو را دارد؟»
آیا بکلینک باعث ایندکس سریعتر میشود؟
یک لینک خارجی میتواند یکی از مسیرهای کشف URL باشد، اما نمیتوان گفت برای ایندکس شدن هر صفحه باید بکلینک خرید.
قبل از فکر کردن به لینک خارجی، مسائل پایهای مانند:
- Crawlability
- Indexability
- Sitemap
- لینک داخلی
- Canonical
- محتوای مستقل و ارزشمند
باید بررسی شوند.
بکلینک بخشی از استراتژی کلی سئو است و نباید آن را یک ابزار مستقیم و تضمینی برای ایندکس سایت در نظر گرفت.
آیا همه صفحات سایت باید ایندکس شوند؟
خیر. یکی از اشتباهات رایج این است که تصور کنیم هرچه درصد صفحات Indexed بیشتر باشد، سایت وضعیت بهتری دارد.
برخی URLها اساساً ارزش حضور در نتایج جستجو ندارند؛ برای مثال:
- صفحات جستجوی داخلی
- برخی URLهای فیلتر و پارامتری
- نسخههای تکراری
- برخی صفحات سیستمی
- صفحات کمارزش یا بدون محتوای مستقل
هدف سئو این نیست که ۱۰۰ درصد URLهای تولیدشده توسط سایت را وارد Index کنیم. هدف، ایندکس شدن صفحات مهم و ارزشمند است.
در این زمینه نیز تنظیم صحیح Canonical و مدیریت درست URLهای مشابه اهمیت زیادی دارد.
چگونه صفحات ایندکسنشده را در Search Console تحلیل کنیم؟
اگر تعداد زیادی صفحه در سایت شما ایندکس نشدهاند، ابتدا به گزارش Page Indexing در Search Console بروید و URLها را بر اساس دلیل عدم ایندکس دستهبندی کنید.
برای مثال، این وضعیتها یک معنی ندارند:
- Excluded by noindex: صفحه با دستور Noindex از Index خارج شده است.
- Crawled – currently not indexed: صفحه Crawl شده اما فعلاً در Index قرار نگرفته است.
- Discovered – currently not indexed: گوگل URL را شناخته اما هنوز آن را Crawl نکرده است.
- Duplicate: گوگل صفحه را مشابه URL دیگری تشخیص داده است.
- Not found: URL قابل دسترسی نیست و معمولاً وضعیت 404 دارد.
بنابراین یکی از مهمترین اصول Technical SEO این است:
برای تمام وضعیتهای Indexing یک راهحل واحد وجود ندارد؛ ابتدا علت را مشخص کنید، سپس اقدام کنید.
همچنین توجه داشته باشید که گزارش Page Indexing یک گزارش لحظهای برای تکتک URLها نیست. برای بررسی دقیق یک URL مشخص، URL Inspection اطلاعات مستقیمتری ارائه میدهد.
یک مثال عملی برای بررسی ایندکس مقاله جدید
فرض کنید مقالهای با عنوان «تأثیر سرعت سایت بر سئو» منتشر کردهاید و میخواهید مطمئن شوید شرایط مناسبی برای ایندکس دارد.
مرحله اول: بررسی Status Code
بررسی کنید URL سالم است و پاسخ موفق HTTP دریافت میکند.
مرحله دوم: بررسی robots.txt
مطمئن شوید مسیر مقاله بهاشتباه توسط robots.txt مسدود نشده است.
مرحله سوم: بررسی Noindex
کد یا تنظیماتی برای جلوگیری از Index شدن صفحه وجود نداشته باشد.
مرحله چهارم: بررسی Canonical
مطمئن شوید Canonical به URL صحیح اشاره میکند.
مرحله پنجم: بررسی Sitemap
اگر مقاله یکی از صفحات مهم سایت است، URL آن باید در Sitemap مناسب سایت قرار داشته باشد.
مرحله ششم: ایجاد لینک داخلی
از چند صفحه مرتبط و قابل دسترس به مقاله جدید لینک دهید.
مرحله هفتم: URL Inspection
URL را در Search Console بررسی کنید و وضعیت Page indexing، Crawl، Indexing و Canonical را ببینید.
مرحله هشتم: Test Live URL
اگر تغییراتی ایجاد کردهاید، نسخه زنده URL را آزمایش کنید تا مشخص شود Google-InspectionTool اکنون میتواند صفحه را دریافت و پردازش کند.
مرحله نهم: Request Indexing
اگر صفحه سالم است و برای سایت اهمیت دارد، میتوانید درخواست Indexing ارسال کنید.
مرحله دهم: بررسی مجدد
بعد از اصلاحات، به گوگل زمان بدهید و وضعیت URL را دوباره بررسی کنید. ارسال مکرر درخواست بدون ایجاد تغییر واقعی، جایگزین عیبیابی نیست.
اگر سایت وردپرسی باشد، چه چیزهایی را برای ایندکس بررسی کنیم؟
در سایتهای وردپرسی، چند بخش میتوانند مستقیماً روی وضعیت Index صفحات اثر بگذارند.
تنظیمات Reading
در تنظیمات وردپرس مطمئن شوید گزینه جلوگیری از نمایش سایت در موتورهای جستجو بهاشتباه فعال نشده باشد. این مشکل گاهی پس از انتقال سایت از محیط توسعه به سایت اصلی باقی میماند.
افزونه SEO
تنظیمات Indexing نوشتهها، صفحات، دستهها، برچسبها و Custom Post Typeها را بررسی کنید. گاهی یک تنظیم اشتباه در افزونه SEO باعث میشود تعداد زیادی URL بهصورت ناخواسته Noindex شوند.
Sitemap
Sitemap تولیدشده توسط افزونه SEO یا سیستم سایت را بررسی کنید و مطمئن شوید URLهای مهم در آن وجود دارند.
Canonical
Canonical مقالات و صفحات مهم را بررسی کنید تا به URL صحیح اشاره کنند.
لینک داخلی
مقاله جدید نباید یک صفحه کاملاً孤立 در سایت باشد. باید از بخشهای مرتبط سایت مسیر منطقی برای دسترسی به آن وجود داشته باشد.
چرا بعضی صفحات وردپرس ایندکس میشوند اما بعضی نه؟
ممکن است ساختار کلی سایت سالم باشد اما هر URL شرایط متفاوتی داشته باشد.
- مقاله A: محتوای مستقل و ارزشمند دارد.
- مقاله B: تقریباً تکرار مقاله A است.
- مقاله C: بهاشتباه Noindex شده است.
- مقاله D: هیچ لینک داخلی مناسبی ندارد.
- مقاله E: Canonical آن روی URL دیگری تنظیم شده است.
در نتیجه نمیتوان صرفاً از روی وضعیت چند صفحه درباره کل سایت نتیجهگیری کرد. هر URL باید بر اساس علت واقعی خودش بررسی شود.
چگونه ایندکس سایت را بهصورت حرفهای بررسی کنیم؟
برای یک Audit حرفهای، فقط جستجوی چند عبارت در گوگل کافی نیست. بهتر است چند منبع داده در کنار هم بررسی شوند.
- Google Search Console: برای بررسی وضعیت Index، Queryها، Crawl و عملکرد صفحات.
- URL Inspection: برای تحلیل دقیق یک URL مشخص.
- Page Indexing: برای مشاهده الگوهای کلی صفحات Indexed و Not Indexed.
- Crawlerهای SEO: برای بررسی گسترده Status Code، Canonical، Noindex و لینکهای داخلی.
- Analytics: برای بررسی رفتار کاربران و ارزش واقعی صفحات.
- Rich Results Test: برای بررسی برخی دادههای ساختاریافته و نحوه پردازش صفحه.
ترکیب این دادهها تصویر بسیار دقیقتری از وضعیت ایندکس سایت ایجاد میکند.
چکلیست بررسی و بهبود ایندکس سایت
پیش از انتشار یک صفحه مهم یا هنگام بررسی صفحات ایندکسنشده، این موارد را کنترل کنید:
- ☑ URL با وضعیت موفق HTTP در دسترس است.
- ☑ صفحه توسط robots.txt بهاشتباه مسدود نشده است.
- ☑ Noindex ناخواسته وجود ندارد.
- ☑ Canonical صحیح است.
- ☑ URL مهم در Sitemap قرار دارد.
- ☑ صفحه از صفحات مرتبط لینک داخلی دریافت میکند.
- ☑ صفحه Duplicate واضح نیست.
- ☑ محتوای صفحه ارزش مستقل دارد.
- ☑ سرور خطاهای مکرر 5xx یا Timeout ندارد.
- ☑ محتوای اصلی توسط JavaScript از دسترس Googlebot خارج نشده است.
- ☑ نسخه موبایل محتوا را بهدرستی ارائه میکند.
- ☑ URL در Search Console بررسی شده است.
- ☑ در صورت نیاز، Test Live URL انجام شده است.
- ☑ در صورت اهمیت صفحه، Request Indexing ارسال شده است.
اشتباهات رایج درباره ایندکس سایت
کلیک کردن مداوم روی Request Indexing
اگر مشکل اصلی Noindex، Duplicate، Canonical یا Crawl باشد، درخواستهای بیشتر راهحل آن نیستند.
قرار دادن تمام URLها در Sitemap
Sitemap باید روی URLهای مهم و قابل نمایش در Search تمرکز داشته باشد، نه تمام URLهایی که سیستم سایت تولید میکند.
تصور اینکه Crawl شدن یعنی Index شدن
Crawl و Index دو مرحله متفاوت هستند و Crawl شدن صفحه تضمین نمیکند که URL وارد Index شود.
تلاش برای ایندکس کردن همه صفحات
برخی URLها اصلاً نباید در Index قرار بگیرند.
خرید بکلینک فقط برای ایندکس
لینک خارجی میتواند به کشف URL کمک کند، اما ابزار تضمینی برای Indexing نیست.
تولید محتوای انبوه و مشابه
تعداد بیشتر URL لزوماً به معنی سایت بهتر یا ایندکس بیشتر نیست.
بیتوجهی به Canonical و Noindex
یک تنظیم اشتباه میتواند صفحات مهم سایت را از Index خارج کند.
نادیده گرفتن Search Console
بدون بررسی دادههای واقعی، بسیاری از تصمیمها درباره ایندکس سایت صرفاً بر اساس حدس انجام میشوند.
نقش ایندکس سایت در استراتژی سئو چیست؟
Indexing تنها یکی از حلقههای زنجیره سئو است.
تحقیق کلمات کلیدی → تولید محتوا → Crawl → Indexing → Ranking → Impression → Click → Conversion
ممکن است یک صفحه عالی باشد اما هنوز ایندکس نشده باشد. ممکن است ایندکس شده باشد اما رتبه نگیرد. ممکن است رتبه داشته باشد اما کلیک کمی دریافت کند و حتی ممکن است ترافیک خوبی داشته باشد اما تبدیل مناسبی ایجاد نکند.
به همین دلیل تحلیل سئو نباید فقط روی تعداد صفحات Indexed تمرکز کند؛ بلکه باید کل مسیر از کشف URL تا دریافت ترافیک و تبدیل کاربر را بررسی کند.
چه زمانی باید ایندکس نشدن صفحات را جدی بگیریم؟
اگر سایت تازه راهاندازی شده باشد، کمی زمان برای کشف و پردازش صفحات طبیعی است. اما وقتی مشکل گسترده یا مداوم است، باید آن را جدیتر بررسی کرد.
- صفحات مهم برای مدت طولانی ایندکس نمیشوند.
- تعداد زیادی URL در وضعیت Not Indexed قرار گرفتهاند.
- تعداد صفحات Indexed بهصورت ناگهانی کاهش یافته است.
- صفحات قدیمی که قبلاً در Index بودهاند از دسترس Search خارج شدهاند.
- Canonicalهای غیرمنتظره مشاهده میکنید.
- صفحات مهم Noindex شدهاند.
- خطاهای Crawl یا Server افزایش یافتهاند.
در این شرایط بهتر است بهجای ارسال درخواستهای بیشتر برای ایندکس، ابتدا علت اصلی مشکل را پیدا کنید.
ایندکس سریع مهمتر است یا ایندکس صحیح؟
در سئو، سرعت بهتنهایی معیار خوبی برای ارزیابی Indexing نیست.
فرض کنید یک صفحه کمارزش و تکراری در چند ساعت ایندکس شود، اما یک صفحه تخصصی و ارزشمند چند روز برای پردازش زمان ببرد. نمیتوان صرفاً از روی سرعت Index نتیجه گرفت که صفحه اول وضعیت بهتری دارد.
هدف اصلی باید این باشد:
«صفحات درست و ارزشمند سایت در اختیار موتور جستجو قرار بگیرند.»
بنابراین بهتر است بهجای وسواس روی تعداد یا سرعت Index، روی کیفیت محتوا، معماری سایت، دسترسی Googlebot و وضعیت صفحات مهم تمرکز کنید.
سوالات متداول درباره ایندکس سایت
ایندکس سایت چیست؟
ایندکس فرایندی است که طی آن گوگل اطلاعات صفحات را پس از پردازش در سیستم Index خود نگهداری میکند تا در صورت مرتبط بودن، امکان استفاده از آنها در نتایج جستجو وجود داشته باشد.
چطور بفهمیم صفحهای در گوگل ایندکس شده است؟
برای بررسی دقیق یک URL، از URL Inspection در Google Search Console استفاده کنید. این ابزار وضعیت Index، Crawl، Canonical و برخی اطلاعات دیگر مربوط به URL را نمایش میدهد.
چگونه سرعت ایندکس سایت را افزایش دهیم؟
Sitemap سالم، لینک داخلی مناسب، معماری منطقی، رفع مشکلات Crawl، مدیریت URLهای غیرضروری، Canonical صحیح، حذف Noindex ناخواسته و تولید محتوای ارزشمند میتوانند شرایط بهتری برای کشف و پردازش صفحات ایجاد کنند؛ اما هیچکدام تضمین ایندکس فوری همه صفحات نیستند.
آیا Request Indexing باعث ایندکس فوری میشود؟
خیر. Request Indexing فقط درخواست بررسی URL را به گوگل ارسال میکند و ایندکس شدن صفحه را تضمین نمیکند.
آیا Sitemap باعث ایندکس شدن همه صفحات میشود؟
خیر. Sitemap به کشف URLها کمک میکند اما تضمینی برای Indexing تمام URLهای موجود در آن نیست.
چرا صفحه من Crawl شده اما ایندکس نشده است؟
ممکن است صفحه Duplicate باشد، ارزش مستقل کافی نداشته باشد، Canonical مناسبی نداشته باشد یا گوگل در حال حاضر آن را برای Indexing انتخاب نکرده باشد. این وضعیت الزاماً به معنی یک خطای فنی نیست.
آیا همه صفحات سایت باید ایندکس شوند؟
خیر. برخی URLهای سیستمی، تکراری، پارامتری، کمارزش یا غیرقابلنمایش ممکن است نیازی به ایندکس شدن نداشته باشند.
آیا بکلینک باعث ایندکس شدن سریعتر میشود؟
لینک خارجی میتواند یکی از مسیرهای کشف URL باشد، اما راهکار تضمینی برای Indexing نیست.
آیا ایندکس شدن یعنی رتبه گرفتن؟
خیر. Indexing و Ranking دو مرحله متفاوت هستند. یک صفحه میتواند ایندکس شده باشد اما برای Query موردنظر رتبه مناسبی نداشته باشد.
جمعبندی؛ ایندکس سایت چیست و چگونه آن را بهبود دهیم؟
ایندکس سایت یکی از مراحل اصلی حضور صفحات در موتور جستجوی گوگل است، اما نباید آن را با Crawl یا Ranking یکی دانست.
گوگل ابتدا باید URL را کشف کند، سپس بتواند آن را Crawl و در صورت نیاز Render کند، محتوای صفحه را پردازش کند و در نهایت تصمیم بگیرد که آیا اطلاعات آن در Index قرار بگیرد یا خیر. بعد از آن، صفحات موجود در Index میتوانند برای جستجوهای مختلف رتبهبندی شوند.
بنابراین اگر یک صفحه در گوگل دیده نمیشود، اولین سؤال نباید این باشد که:
«چطور دوباره Request Indexing بفرستم؟»
بلکه باید بپرسیم:
«صفحه دقیقاً در کدام مرحله متوقف شده است؟»
اگر URL هنوز کشف نشده است، Sitemap و لینک داخلی را بررسی کنید.
اگر Crawl انجام نمیشود، robots.txt، وضعیت سرور، دسترسی Googlebot و مشکلات شبکه را بررسی کنید.
اگر صفحه Crawl شده اما Index نشده است، Duplicate بودن، Canonical، ارزش مستقل محتوا و نحوه Render شدن صفحه را بررسی کنید.
اگر صفحه Index شده اما رتبه نمیگیرد، مشکل دیگر صرفاً مربوط به ایندکس نیست و باید سراغ محتوا، Search Intent، رقبا و عوامل رتبهبندی رفت.
در نهایت، برای بهبود وضعیت ایندکس سایت باید مجموعهای از اقدامات را در کنار هم انجام دهید:
- Sitemap سالم
- لینکسازی داخلی مناسب
- ساختار منطقی سایت
- Canonical صحیح
- عدم وجود Noindex ناخواسته
- سرور پایدار و قابل دسترس
- مدیریت URLهای غیرضروری
- محتوای مستقل و ارزشمند
- بررسی منظم Search Console
در پروژههای سئو، طراحی سایت و پشتیبانی سایت پرشیا وب نیز ایندکس نباید صرفاً با تعداد صفحات Indexed سنجیده شود. سؤال اصلی این است که آیا صفحات ارزشمند سایت بهدرستی کشف، Crawl و Index میشوند و آیا ساختار فنی و محتوایی سایت شرایط مناسبی برای حضور آنها در نتایج جستجو ایجاد کرده است یا خیر.
هدف سئو، ایندکس کردن هرچه بیشتر صفحات نیست؛ هدف، قرار دادن صفحات درست و ارزشمند در اختیار موتور جستجو است.
