محتوای تکراری یا Duplicate Content به وضعیتی گفته میشود که یک محتوا یا بخش قابلتوجهی از آن در بیش از یک آدرس اینترنتی (URL) در دسترس باشد. این آدرسها ممکن است در یک سایت قرار داشته باشند یا محتوای یکسان در چند وبسایت مختلف منتشر شده باشد.
برای مثال، فرض کنید یک فروشگاه اینترنتی صفحهای برای معرفی یک دستگاه قهوهساز دارد، اما همان محتوا از طریق چند آدرس مختلف نمایش داده میشود:
https://example.com/product/coffee-maker/
https://example.com/product/coffee-maker/?color=black
https://example.com/product/coffee-maker/?sort=price
اگر این صفحات تفاوت محتوایی قابلتوجهی نداشته باشند، موتور جستجو با چند URL روبهرو میشود که محتوای یکسان یا بسیار مشابهی ارائه میکنند. در چنین شرایطی، ممکن است لازم باشد نسخه اصلی محتوا مشخص شود یا ساختار URLها اصلاح شود.
البته هر محتوای تکراری الزاماً مشکل سئویی یا جریمه گوگل نیست. گوگل بهصورت طبیعی با نسخههای مشابه یک صفحه مواجه میشود و تلاش میکند یک URL را بهعنوان نسخه اصلی یا Canonical انتخاب کند. مسئله زمانی اهمیت بیشتری پیدا میکند که نسخههای متعدد باعث انتخاب URL نامناسب، ایجاد صفحات غیرضروری یا دشوار شدن مدیریت خزش و ایندکس شوند.
بنابراین، برای مدیریت Duplicate Content باید مشخص کنیم تکرار محتوا به چه دلیلی ایجاد شده، کدام صفحه باید در نتایج جستجو نمایش داده شود و آیا واقعاً به تمام نسخههای موجود نیاز داریم یا خیر.
آیا محتوای تکراری باعث جریمه گوگل میشود؟
یکی از باورهای رایج در سئو این است که وجود هر صفحه تکراری باعث پنالتی شدن سایت میشود؛ اما این تصور دقیق نیست. طبق راهنمای گوگل، وجود محتوای تکراری در حالت عادی نقض سیاستهای اسپم محسوب نمیشود. موتور جستجو معمولاً صفحات مشابه را شناسایی میکند و سعی میکند نسخه مناسبتر را برای نمایش در نتایج انتخاب کند.
برای مثال، اگر نسخه HTTP و HTTPS یک صفحه بهصورت همزمان در دسترس باشند، این موضوع لزوماً به معنای جریمه سایت نیست؛ اما بهتر است نسخه ترجیحی بهدرستی مشخص شود تا کاربران و موتورهای جستجو به آدرس مناسب هدایت شوند.
شرایط زمانی متفاوت میشود که صفحات متعدد عمداً برای دستکاری نتایج جستجو ساخته شوند یا محتوای سایتهای دیگر بدون ارزش افزوده قابلتوجه بازنشر شود. چنین رفتارهایی، بسته به شرایط، ممکن است با سیاستهای اسپم گوگل مرتبط باشند.
نکته اصلی: بهجای اینکه هر صفحه مشابه را خطر جریمه بدانید، بررسی کنید آیا URLهای تکراری ضروری هستند، گوگل نسخه مناسبی را انتخاب کرده است و هر صفحه برای کاربر ارزش مستقل دارد یا خیر.
تفاوت محتوای تکراری با محتوای کپیشده چیست؟
این دو مفهوم با یکدیگر ارتباط دارند، اما دقیقاً یکسان نیستند. محتوای تکراری به وجود محتوای یکسان یا بسیار مشابه در چند URL اشاره میکند؛ درحالیکه محتوای کپیشده معمولاً به برداشتن محتوا از منبعی دیگر و انتشار مجدد آن گفته میشود.
برای مثال، اگر یک مقاله در دو آدرس از سایت خودتان قابل دسترسی باشد، ممکن است با Duplicate Content فنی روبهرو باشید، حتی اگر هیچکس محتوای دیگری را کپی نکرده باشد. در مقابل، اگر وبسایتی مقاله شما را بدون اجازه در سایت خود منتشر کند، مسئله کپیبرداری از محتوا نیز مطرح میشود.
همچنین تغییر چند واژه یا جایگزین کردن کلمات با مترادفها، لزوماً یک محتوای کپیشده را به مطلبی مستقل و ارزشمند تبدیل نمیکند. برای ایجاد ارزش واقعی، محتوا باید اطلاعات، تحلیل، تجربه یا پاسخ متفاوتی در اختیار مخاطب قرار دهد.
محتوای تکراری چگونه ایجاد میشود؟
Duplicate Content همیشه نتیجه کپی کردن مقاله از سایت دیگر نیست. بسیاری از موارد به ساختار فنی سایت، تنظیمات سیستم مدیریت محتوا یا شیوه انتشار صفحات مربوط میشوند.
۱. وجود چند URL برای یک صفحه
گاهی یک صفحه با چند آدرس متفاوت در دسترس است. برای نمونه، تفاوت اسلش انتهایی یا وجود پارامترهای غیرضروری میتواند نسخههای مختلفی از یک URL ایجاد کند:
https://example.com/article
https://example.com/article/

https://example.com/product?id=25
https://example.com/product/coffee-maker/
تفاوت ظاهری آدرسها بهتنهایی اثبات نمیکند که محتوای تکراری وجود دارد؛ مهم این است که سرور چه محتوایی برمیگرداند و آیا این آدرسها به صفحات مستقل یا نسخههای مشابه منتهی میشوند. در صورت وجود نسخههای غیرضروری، باید یک ساختار مشخص برای URLها انتخاب شود.
۲. صفحات فیلتر و مرتبسازی در فروشگاهها
فروشگاههای اینترنتی به دلیل فیلترهایی مانند رنگ، سایز، برند و مرتبسازی قیمت، مستعد ایجاد URLهای متعدد هستند. ممکن است کاربر با انتخاب چند فیلتر به آدرسی برسد که تفاوت محتوایی آن با صفحه اصلی دستهبندی بسیار کم است.
اگر تعداد زیادی از این URLها بدون برنامه مشخص در دسترس موتورهای جستجو قرار بگیرند، مدیریت خزش و ایندکس پیچیدهتر میشود. البته بعضی صفحات فیلترشده، مانند یک دستهبندی با تقاضای جستجوی مشخص و محصولات مرتبط، ممکن است ارزش مستقل داشته باشند؛ بنابراین نباید تمام صفحات فیلتر را بدون بررسی مسدود یا حذف کرد.
این موضوع در کنار ساختار ایندکس سایت اهمیت دارد.
پیشنهاد مطالعه: چرا گوگل سایت شما را ایندکس نمیکند؟
۳. نسخههای HTTP و HTTPS
اگر تنظیمات سرور بهدرستی انجام نشده باشد، ممکن است یک محتوا از طریق هر دو نسخه HTTP و HTTPS در دسترس باشد:
http://example.com/page/
https://example.com/page/
در این حالت، معمولاً باید نسخه HTTPS بهعنوان نسخه ترجیحی انتخاب شود و نسخه HTTP با ریدایرکت دائمی به آن هدایت شود. صرف انتخاب HTTPS در تنظیمات وردپرس کافی نیست؛ باید بررسی کنید که نسخه HTTP واقعاً به آدرس صحیح منتقل میشود.
۴. نسخههای www و بدون www
یک مسئله مشابه میتواند میان نسخههای دارای www و بدون آن رخ دهد:
https://www.example.com/
https://example.com/
اگر هر دو نسخه محتوای یکسانی نمایش دهند، بهتر است یکی را بهعنوان آدرس اصلی دامنه انتخاب کنید و نسخه دیگر را با ریدایرکت مناسب به آن منتقل کنید. انتخاب نسخه اصلی باید در لینکهای داخلی، نقشه سایت و تنظیمات Canonical نیز منعکس شود.
۵. نسخههای آزمایشی و قدیمی سایت
گاهی نسخه آزمایشی یا توسعهای سایت روی یک زیر دامنه یا آدرس جداگانه قرار میگیرد و پس از انتشار نسخه اصلی، دسترسی موتورهای جستجو به نسخه آزمایشی مدیریت نمیشود. در نتیجه، محتوای مشابه در چند محل قابل دسترسی خواهد بود.
پس از انتقال سایت به دامنه اصلی، بررسی کنید نسخه آزمایشی بهطور ناخواسته در نتایج جستجو ظاهر نشده باشد. راهکار مناسب به وضعیت آن بستگی دارد؛ نسخه آزمایشی نباید بهعنوان یک سایت مستقل و قابل ایندکس باقی بماند.
۶. انتشار توضیحات یکسان برای محصولات یا خدمات
اگر چند فروشگاه از توضیحات رسمی یکسانی برای معرفی یک محصول استفاده کنند، متن صفحات آنها ممکن است شباهت زیادی داشته باشد. این وضعیت الزاماً به معنی جریمه شدن فروشگاهها نیست، اما ممکن است فرصت مناسبی برای ارائه ارزش افزوده باشد.
برای متمایز شدن صفحه، میتوانید مشخصات کاربردی، تصاویر اختصاصی، تجربه استفاده، پاسخ به پرسشهای خریداران، مقایسه با مدلهای دیگر و راهنمای انتخاب محصول را اضافه کنید. هدف، صرفاً تغییر جملهها نیست؛ باید اطلاعاتی ارائه دهید که به تصمیمگیری بهتر کاربر کمک کند.
۷. کپی شدن محتوا در سایتهای دیگر
ممکن است سایت دیگری مقاله شما را بدون اجازه بازنشر کند یا یک محتوا با هدف انتشار در چند رسانه در دسترس قرار بگیرد. در این وضعیت باید میان انتشار مجدد مجاز، بازنشر محتوای خبری و کپیبرداری بدون اجازه تفاوت قائل شد.
اگر محتوای شما بدون اجازه کپی شده است، ابتدا نسخههای منتشرشده و تاریخ انتشار را بررسی کنید. در صورت لزوم، میتوانید از مدیر سایت یا میزبان درخواست حذف محتوا کنید و در موارد مرتبط با نقض حقوق مؤلف، مسیر قانونی مناسب را پیگیری کنید. صرف مشاهده یک متن مشابه، بهتنهایی ثابت نمیکند که گوگل نسخه اشتباه را انتخاب کرده یا سایت شما جریمه شده است.
پیشنهاد مطالعه : Schema Markup چیست؟
تأثیر محتوای تکراری بر سئو چیست؟
تأثیر Duplicate Content به نوع تکرار، تعداد URLها و نحوه مدیریت صفحات بستگی دارد. مهمترین پیامدهای احتمالی عبارتاند از:
انتخاب URL نامناسب توسط گوگل
وقتی چند URL محتوای مشابهی دارند، ممکن است گوگل نسخهای را انتخاب کند که با انتخاب مدیر سایت متفاوت است. برای مثال، بهجای آدرس اصلی مقاله، نسخهای دارای پارامتر یا URL قدیمی در نتایج جستجو نمایش داده شود.
در Google Search Console میتوانید با ابزار URL Inspection بررسی کنید گوگل چه URLی را بهعنوان Canonical انتخاب کرده است. مشاهده پیام Google chose a different canonical than user به این معناست که گوگل نسخه دیگری را ترجیح داده است؛ اما برای یافتن علت باید سیگنالهای فنی و محتوایی را بررسی کنید.
پراکنده شدن سیگنالها میان URLهای مشابه
اگر لینکهای داخلی و خارجی به چند نسخه از یک محتوا اشاره کنند، سیگنالهای مرتبط با آن محتوا ممکن است میان URLها پراکنده شوند. انتخاب نسخه اصلی و هماهنگ کردن لینکهای داخلی با آن، به گوگل کمک میکند ارتباط میان صفحات مشابه را بهتر درک کند.
مصرف منابع خزش برای URLهای غیرضروری
در سایتهای بزرگ، تعداد زیادی URL ناشی از فیلترها، پارامترها و صفحات مشابه میتواند منابع خزش را به سمت آدرسهایی هدایت کند که ارزش مستقلی ندارند. اهمیت این مسئله به اندازه سایت، الگوی خزش و تعداد URLهای غیرضروری بستگی دارد؛ بنابراین هر سایت کوچکی با چند صفحه مشابه الزاماً مشکل بودجه خزش ندارد.
دشواری تحلیل عملکرد صفحات
وقتی چند URL به محتوای تقریباً یکسان مربوط باشند، بررسی کلیکها، بازدیدها و عملکرد صفحات دشوارتر میشود. مدیریت نسخه اصلی میتواند گزارشگیری را سادهتر کند و به تحلیل دقیقتر عملکرد محتوا کمک کند.
چگونه محتوای تکراری را در سایت تشخیص دهیم؟
قبل از حذف، ادغام یا تغییر صفحات، باید مشخص کنید تکرار از کجا ایجاد شده است. حذف یک URL بدون بررسی لینکهای داخلی، ریدایرکتها و ارتباط آن با صفحات دیگر ممکن است به تجربه کاربر و سئو آسیب بزند.
۱. بررسی Google Search Console
برای شروع، وارد Google Search Console شوید و گزارش Pages را بررسی کنید. وضعیتهایی مانند Duplicate without user-selected canonical یا Duplicate, Google chose different canonical than user میتوانند سرنخهایی درباره نحوه تشخیص نسخههای مشابه توسط گوگل ارائه دهند.
برای بررسی یک آدرس مشخص، از ابزار URL Inspection استفاده کنید. در اطلاعات ایندکسشدن صفحه، URL کنونیکال اعلامشده توسط سایت و URL کنونیکال انتخابشده توسط گوگل را با یکدیگر مقایسه کنید. این گزارش بهتنهایی علت مشکل را مشخص نمیکند، اما نقطه شروع مناسبی برای بررسی است.
اگر گوگل نسخه دیگری را انتخاب کرده است، مواردی مانند Canonical اشتباه، ریدایرکتها، لینکهای داخلی، نقشه سایت و شباهت واقعی محتوا را بررسی کنید. پس از اصلاح، ممکن است مدتی طول بکشد تا گوگل صفحات را دوباره ارزیابی کند.
۲. بررسی URLهای مشابه
آدرسهای سایت را از نظر موارد زیر بررسی کنید:
- نسخه HTTP و HTTPS و نسخههای www و بدون www
- اسلش انتهایی و تفاوتهای غیرضروری در ساختار URL
- پارامترهای فیلتر، مرتبسازی و رهگیری
- صفحات چاپ و نسخههای جایگزین محتوا
- صفحات جستجوی داخلی، آرشیوها، دستهبندیها و برچسبها
- نسخههای آزمایشی و URLهای قدیمی
- صفحات محصول یا مقالهای که محتوای بسیار مشابهی دارند
در وردپرس، افزونهها، قالبها و تنظیمات فروشگاه نیز ممکن است URLهای اضافی ایجاد کنند. لازم است هر مورد را جداگانه بررسی کنید؛ زیرا وجود یک نوع URL در سایت لزوماً به این معنا نیست که باید آن را حذف یا از ایندکس خارج کرد.
۳. مقایسه محتوای صفحات مشابه
گاهی URLها از نظر فنی متفاوت هستند، اما محتوای آنها تقریباً یکسان است. برای مثال، دو صفحه با عنوانهای «خرید بلیط هواپیما تهران» و «رزرو بلیط هواپیما تهران» ممکن است اطلاعات، پیشنهادها و ساختار مشابهی داشته باشند.
در این وضعیت، فقط به عنوان صفحه توجه نکنید. هدف جستجو، اطلاعات اصلی، نوع خدمات، مخاطب و ارزش کاربردی هر صفحه را مقایسه کنید. اگر دو صفحه عملاً یک نیاز را پاسخ میدهند، ادغام آنها میتواند منطقی باشد؛ اما اگر هرکدام هدف مستقل و محتوای مفیدی دارند، لزوماً نباید یکی حذف شود.
بهترین روشهای رفع Duplicate Content
روش درست به علت تکرار بستگی دارد. Canonical، ریدایرکت 301، Noindex و robots.txt کاربردهای متفاوتی دارند و نباید آنها را بهجای یکدیگر استفاده کرد.
۱. استفاده از Canonical
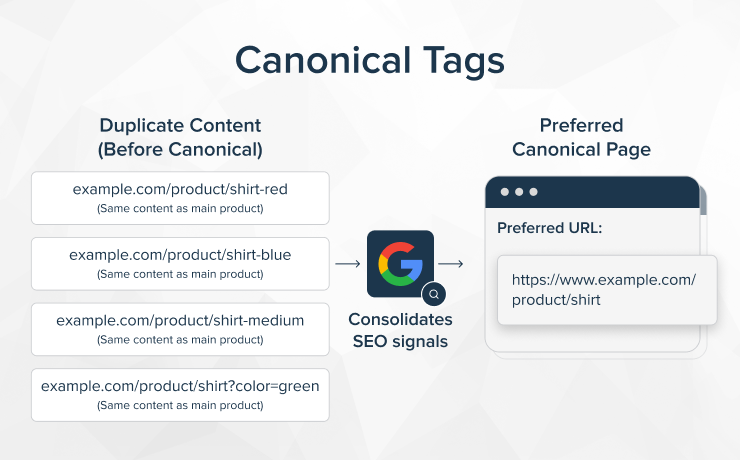
اگر چند URL محتوای یکسان یا بسیار مشابه دارند و لازم است نسخههای دیگر همچنان برای کاربران در دسترس باشند، میتوان از تگ rel="canonical" برای معرفی URL ترجیحی استفاده کرد.
برای مثال، اگر صفحه اصلی محصول آدرس زیر را دارد:
https://example.com/product/coffee-maker/نسخه دارای پارامتر میتواند در بخش head صفحه به آن اشاره کند:
<link rel="canonical" href="https://example.com/product/coffee-maker/" />این تگ به گوگل اعلام میکند کدام URL را نسخه ترجیحی میدانید؛ اما یک دستور قطعی نیست. گوگل ممکن است با توجه به سایر سیگنالها URL دیگری را انتخاب کند. بنابراین آدرس Canonical باید قابل دسترسی، مرتبط با محتوا و ترجیحاً بهصورت یکپارچه در کل سایت استفاده شود.
چه زمانی Canonical مناسب است؟
Canonical معمولاً زمانی مناسب است که نسخههای مشابه باید در سایت باقی بمانند، اما میخواهید یک URL بهعنوان نسخه اصلی معرفی شود. برای مثال، ممکن است URL دارای پارامترهای رهگیری یا برخی حالتهای نمایش محصول همچنان برای کاربر کاربرد داشته باشد، درحالیکه قصد ندارید همه آنها بهعنوان صفحات مستقل در نتایج جستجو نمایش داده شوند.
اگر دو صفحه تفاوت محتوایی مهمی دارند یا پاسخگوی نیازهای متفاوت کاربران هستند، نباید صرفاً برای کاهش تعداد URLها، Canonical یکی را به دیگری اشاره دهید.
۲. استفاده از ریدایرکت 301
اگر یک URL قدیمی دیگر نباید بهصورت مستقل در دسترس باشد و صفحه دیگری جایگزین آن شده است، ریدایرکت 301 معمولاً راهکار مناسبی است.
برای مثال، اگر صفحه قدیمی محصول با آدرس زیر جای خود را به صفحه جدید داده باشد:
https://example.com/product-old/
https://example.com/product-new/میتوان URL قدیمی را به صفحه جدید و مرتبط هدایت کرد. ریدایرکت دائمی سیگنال قدرتمندی برای انتخاب URL مقصد است و برای ادغام نسخههای قدیمی و جدید کاربرد دارد. بااینحال، مقصد ریدایرکت باید واقعاً جایگزین مناسبی برای صفحه قبلی باشد؛ هدایت همه URLهای حذفشده به صفحه اصلی معمولاً تجربه خوبی برای کاربر ایجاد نمیکند.
قاعده ساده: اگر URL قدیمی دیگر نباید بهصورت مستقل استفاده شود، ریدایرکت را بررسی کنید. اگر URL باید باقی بماند اما نسخه اصلی دیگری دارد، Canonical معمولاً انتخاب مناسبتری است.
۳. ادغام صفحات مشابه
گاهی بهترین راهحل، ترکیب محتوای دو صفحه در یک مطلب کاملتر است. فرض کنید دو مقاله درباره مراقبت از یک نوع گیاه دارید که تقریباً اطلاعات یکسانی ارائه میکنند. میتوانید نکات مفید هر دو را در یک راهنمای جامعتر ادغام کنید و در صورت مناسب بودن، URL صفحه ضعیفتر را به صفحه نهایی ریدایرکت کنید.
پیش از ادغام، آمار بازدید، رتبه کلمات کلیدی، لینکهای ورودی و تفاوت هدف جستجوی صفحات را بررسی کنید. دو صفحه با موضوع نزدیک الزاماً تکراری نیستند؛ ادغام زمانی منطقی است که محتوای آنها همپوشانی قابلتوجهی داشته باشد و یک صفحه بتواند نیاز کاربران هر دو را بهتر پاسخ دهد.
۴. ایجاد محتوای واقعاً متفاوت
تغییر چند جمله، عنوان یا واژه بهتنهایی برای رفع مشکل محتوای مشابه کافی نیست. اگر دو صفحه هدف، اطلاعات و پاسخ تقریباً یکسانی دارند، باید بررسی کنید آیا واقعاً دلیلی برای نگهداری هر دو وجود دارد یا خیر.
برای مثال، مقاله «روش نگهداری از گل رز» میتواند راهنمای عمومی مراقبت باشد، درحالیکه مقالهای درباره «درمان لکههای سیاه روی برگ گل رز» به یک مشکل مشخص میپردازد. اگر محتوای هر صفحه متناسب با هدف خود نوشته شده باشد، موضوع مشترک بهتنهایی دلیل ادغام آنها نیست.
برای تعیین تفاوت واقعی صفحات، هدف کاربر، نوع اطلاعات، زاویه بررسی و ارزش کاربردی هر محتوا را مقایسه کنید.
۵. مدیریت URLهای فیلتر و پارامتری
در فروشگاههای اینترنتی، ابتدا مشخص کنید کدام صفحات فیلترشده واقعاً تقاضای جستجوی مستقل دارند و کدامیک فقط حالتهای موقتی از یک دستهبندی هستند. صفحات دارای ارزش مستقل ممکن است به محتوای اختصاصی و ساختار مشخص نیاز داشته باشند؛ در مقابل، تعداد زیادی از ترکیبهای فیلتر و مرتبسازی ممکن است URLهای غیرضروری ایجاد کنند.
برای مدیریت این وضعیت میتوان بر اساس نوع صفحه از Canonical، ریدایرکت، کنترل لینکسازی داخلی یا راهکارهای فنی مناسب استفاده کرد. تصمیم نهایی باید با نحوه عملکرد فیلترها و نیاز کاربران هماهنگ باشد؛ استفاده یکسان از یک دستور برای تمام پارامترها همیشه درست نیست.
۶. مدیریت محتوای منتشرشده در سایتهای دیگر
اگر محتوای شما در سایت دیگری بازنشر میشود، ابتدا مشخص کنید انتشار با اجازه شما انجام شده یا بدون اجازه صورت گرفته است. در انتشار مجاز، بهتر است درباره نسخهای که قرار است در نتایج جستجو نمایش داده شود با ناشر هماهنگ کنید.
تگ Canonical بین دو دامنه همیشه راهکار قابل اتکایی برای جلوگیری از نمایش نسخه بازنشرشده نیست. گوگل در برخی شرایط برای محتوای Syndicated توصیه میکند ناشر نسخه بازنشرشده را از ایندکس شدن خارج کند. راهکار مناسب به ساختار انتشار و میزان کنترل شما بر سایت مقصد بستگی دارد.
اگر سایت دیگری محتوای شما را بدون اجازه کپی کرده است، میتوانید ابتدا با مدیر سایت یا میزبان آن تماس بگیرید و در صورت نیاز از روشهای رسمی گزارش نقض حقوق مؤلف استفاده کنید.
آیا Noindex راهحل Duplicate Content است؟
استفاده از نوایندکس یکی از روشهایی است که گاهی برای مدیریت صفحات مشابه پیشنهاد میشود، اما Noindex و Canonical هدف یکسانی ندارند.
دستور noindex به موتور جستجو اعلام میکند که صفحه در نتایج جستجو نمایش داده نشود. در مقابل، Canonical برای معرفی نسخه ترجیحی میان صفحات یکسان یا بسیار مشابه به کار میرود. اگر هدف شما متمرکز کردن سیگنالهای صفحات مشابه روی یک URL است، گوگل توصیه میکند از Canonical استفاده کنید، نه اینکه صرفاً نسخههای دیگر را Noindex کنید.
بهطور خلاصه:
- Canonical: این URL نسخه ترجیحی محتوا نیست؛ نسخه اصلی موردنظر من URL دیگری است.
- Noindex: نمیخواهم این صفحه در نتایج جستجو نمایش داده شود.
برای انتخاب دستور مناسب، ابتدا هدف صفحه و رابطه آن با URLهای دیگر را مشخص کنید.
آیا robots.txt برای حذف Duplicate Content مناسب است؟
خیر. فایل robots.txt برای مدیریت دسترسی خزندهها به بخشهای سایت استفاده میشود و ابزار مناسبی برای تعیین URL اصلی یا حذف مستقیم یک صفحه از نتایج جستجو نیست.
اگر دسترسی خزنده به یک URL را مسدود کنید، ممکن است گوگل همچنان از طریق لینکهای دیگر از وجود آن URL مطلع شود، اما نتواند محتوای صفحه یا دستورهای موجود در آن را بخواند. بنابراین اگر هدف شما تعیین نسخه اصلی است، از Canonical یا ریدایرکت متناسب با شرایط استفاده کنید. اگر هدف جلوگیری از نمایش یک صفحه در نتایج است، باید روش صحیح Noindex را بررسی کنید و مانع خزش صفحه برای خواندن این دستور نشوید.
تفاوت Duplicate Content با Thin Content چیست؟
Duplicate Content به محتوای یکسان یا بسیار مشابه در چند URL اشاره دارد؛ اما Thin Content به صفحاتی گفته میشود که ارزش یا اطلاعات کافی برای کاربر ارائه نمیکنند.
برای مثال، یک سایت ممکن است دهها صفحه درباره انواع گیاهان داشته باشد که هرکدام فقط دو جمله عمومی دارند. این صفحات ممکن است تکراری نباشند، اما از نظر ارزش محتوایی ضعیف باشند. از طرف دیگر، یک صفحه محصول ممکن است محتوای کامل و مفیدی داشته باشد، اما بهدلیل تنظیمات فنی از چند URL قابل دسترسی باشد.
بنابراین این دو مشکل باید جداگانه بررسی شوند: در Duplicate Content باید رابطه صفحات و URLها را مدیریت کرد؛ در Thin Content باید ارزش و کیفیت پاسخ صفحه به نیاز کاربر را بهبود داد.
تفاوت Duplicate Content با Keyword Cannibalization چیست؟
Keyword Cannibalization یا همنوعخواری کلمات کلیدی زمانی مطرح میشود که چند صفحه از یک سایت برای موضوع یا عبارتهای جستجوی مشابه رقابت کنند. این صفحات لزوماً محتوای تکراری ندارند.
برای مثال، دو مقاله درباره «آموزش آشپزی با فر» و «تنظیم دمای فر برای پخت کیک» ممکن است موضوعات نزدیکی داشته باشند، اما هرکدام هدف و اطلاعات مستقلی ارائه کنند. در مقابل، اگر دو صفحه تقریباً یک مطلب را با URLهای متفاوت منتشر کنند، مسئله Duplicate Content مطرح میشود.
برای تشخیص همنوعخواری، عملکرد صفحات در Search Console، عبارتهایی که برای آنها نمایش میگیرند و تفاوت هدف جستجوی هر صفحه را بررسی کنید. راهحل ممکن است اصلاح هدف محتوا، بهبود لینکسازی داخلی یا ادغام صفحات باشد؛ نه اینکه صرفاً برای تمام صفحات Canonical یکسان تعریف کنید.
چکلیست رفع محتوای تکراری
اگر در سایت خود با Duplicate Content مواجه شدهاید، مراحل زیر را بهترتیب انجام دهید:
- URLهای مشابه را از طریق Search Console و بررسی ساختار سایت شناسایی کنید.
- مشخص کنید صفحات واقعاً تکراری هستند یا فقط موضوعات نزدیک دارند.
- URL اصلی موردنظر را بر اساس هدف صفحه و نیاز کاربران انتخاب کنید.
- بررسی کنید نسخههای دیگر باید برای کاربران باقی بمانند یا خیر.
- برای URLهایی که دیگر نباید مستقل باشند، ریدایرکت مرتبط را بررسی کنید.
- برای نسخههای مشابهی که باید باقی بمانند، Canonical مناسب تعریف کنید.
- لینکهای داخلی را تا حد امکان به URL ترجیحی هدایت کنید.
- نقشه سایت را با URLهای اصلی و قابل ایندکس هماهنگ کنید.
- صفحات فیلتر، پارامترها، نسخههای قدیمی و تنظیمات دامنه را بررسی کنید.
- در URL Inspection، نسخه Canonical انتخابشده توسط گوگل را کنترل کنید.
- پس از اصلاح، برای URLهای مهم درخواست ایندکس مجدد ارسال کنید و وضعیت را در روزهای بعد بررسی کنید.
نقشه سایت نیز یکی از سیگنالهای انتخاب URL ترجیحی است، اما سیگنال ضعیفتری نسبت به ریدایرکت و rel="canonical" محسوب میشود. بنابراین صرف قرار دادن یک URL در نقشه سایت همیشه برای حل مشکل کافی نیست؛ سیگنالهای مختلف باید تا حد امکان هماهنگ باشند.

چگونه از ایجاد Duplicate Content در آینده جلوگیری کنیم؟
پیشگیری از ایجاد URLهای تکراری معمولاً آسانتر از بررسی تعداد زیادی صفحه پس از ایندکس شدن آنهاست. هنگام طراحی یا توسعه سایت، مشخص کنید کدام URLها باید قابل ایندکس باشند و کدام آدرسها صرفاً برای عملکرد داخلی سایت ایجاد میشوند.
در سایتهای وردپرسی، تنظیمات نشانی سایت، ساختار پیوندهای یکتا، افزونههای سئو، آرشیوها و صفحات فروشگاهی را بررسی کنید. پس از تغییر دامنه یا انتقال سایت نیز باید ریدایرکتها، Canonicalها، لینکهای داخلی و نقشه سایت با یکدیگر هماهنگ باشند.
هنگام انتشار محتوا نیز پیش از ساخت صفحهای جدید، مقالات قبلی را بررسی کنید. اگر صفحه موجود پاسخ مناسبی به همان نیاز میدهد، بهروزرسانی آن ممکن است انتخاب بهتری از انتشار مقالهای تقریباً مشابه باشد. در مقابل، اگر نیاز کاربر متفاوت است، محتوای جدید باید پاسخ مستقل و ارزشمندی ارائه کند.
پرسشهای متداول درباره محتوای تکراری
آیا محتوای تکراری باعث افت رتبه سایت میشود؟
نه لزوماً. وجود محتوای تکراری بهخودیخود به معنای جریمه نیست. بااینحال، URLهای متعدد و غیرضروری ممکن است باعث انتخاب نسخه نامناسب، پراکندگی سیگنالها یا دشوار شدن مدیریت خزش و ایندکس شوند. اثر واقعی به شرایط سایت بستگی دارد.
آیا برای هر صفحه تکراری باید Canonical تعریف کنیم؟
خیر. ابتدا مشخص کنید آیا صفحه باید مستقل باقی بماند. اگر URL قدیمی دیگر کاربرد ندارد، ریدایرکت میتواند مناسبتر باشد؛ اگر دو صفحه هدفهای متفاوتی دارند، ممکن است هرکدام به URL مستقل نیاز داشته باشند. Canonical برای معرفی نسخه ترجیحی میان صفحات یکسان یا بسیار مشابه استفاده میشود.
اگر سایت دیگری مقاله من را کپی کند، باید چه کار کنم؟
ابتدا نسخه منتشرشده، تاریخ انتشار و وضعیت بازنشر را بررسی کنید. در صورت کپیبرداری بدون اجازه، میتوانید از مدیر سایت یا میزبان درخواست حذف محتوا کنید و در صورت لزوم از مسیرهای رسمی مرتبط با حقوق مؤلف استفاده کنید. لازم نیست صرف مشاهده یک نسخه کپیشده، تمام صفحات سایت خود را تغییر دهید.
آیا تغییر عنوان و چند جمله، Duplicate Content را برطرف میکند؟
نه همیشه. اگر هدف جستجو، اطلاعات اصلی و پاسخ دو صفحه همچنان یکسان باشد، تغییرات جزئی ممکن است تفاوت معناداری ایجاد نکند. صفحات باید بر اساس نیاز واقعی کاربر، اطلاعات و ارزش ارائهشده بررسی شوند.
جمعبندی
محتوای تکراری یا Duplicate Content زمانی ایجاد میشود که یک محتوا یا محتوای بسیار مشابه در چند URL در دسترس باشد. این وضعیت ممکن است به دلایل فنی مانند پارامترهای URL، فیلترهای فروشگاهی، نسخههای مختلف دامنه یا تنظیمات سیستم مدیریت محتوا ایجاد شود؛ همچنین ممکن است محتوای مشابه در چند سایت منتشر شده باشد.
وجود محتوای تکراری بهخودیخود به معنی جریمه شدن توسط گوگل نیست. مسئله مهم این است که آیا نسخه اصلی بهدرستی مشخص شده، صفحات غیرضروری ایجاد نشدهاند و هر URL برای کاربر هدف و ارزش مشخصی دارد یا خیر.
برای رفع مشکل، ابتدا علت تکرار را شناسایی کنید و سپس بر اساس شرایط از Canonical، ریدایرکت 301، ادغام صفحات یا اصلاح ساختار URL استفاده کنید. Noindex و robots.txt نیز کاربردهای متفاوتی دارند و نباید جایگزین خودکار Canonical شوند.
اگر تعداد زیادی URL مشابه در سایت وجود دارد یا گوگل نسخهای متفاوت از URL موردنظر شما را انتخاب میکند، بررسی تخصصی سئو تکنیکال و ساختار ایندکس سایت میتواند به شناسایی علت و انتخاب راهکار مناسب کمک کند.
اگر برای بررسی یا رفع مشکلات فنی سایت به کمک نیاز دارید، میتوانید با کارشناسان پرشیا وب در بخش تعمیر و پشتیبانی سایت در تماس باشید.
