ممکن است یک سایت صدها، هزاران یا حتی میلیونها URL داشته باشد، اما همه این URLها برای موتورهای جستجو ارزش یکسانی نداشته باشند. در چنین شرایطی ممکن است Googlebot بخشی از منابع خود را صرف صفحات تکراری، URLهای پارامتری، فیلترها، Redirectها یا صفحات کماهمیت کند و در نتیجه خزش بخشهای مهم سایت با اولویت پایینتری انجام شود.
اینجاست که مفهوم بودجه خزش یا Crawl Budget اهمیت پیدا میکند.
اما بودجه خزش دقیقاً چیست؟ آیا همه سایتها باید نگران آن باشند؟ چه عواملی باعث کاهش کارایی Crawl میشوند؟ آیا افزایش سرعت سایت یا استفاده از robots.txt واقعاً Crawl Budget را افزایش میدهد؟ و مهمتر از همه، چطور میتوان فهمید Googlebot منابع خود را در سایت ما صرف چه URLهایی میکند؟
در این راهنمای آموزشی از پرشیا وب، موضوع بودجه خزش را از تعریف اولیه تا تحلیل حرفهای در Google Search Console بررسی میکنیم و به سراغ راهکارهایی میرویم که در سایتهای بزرگ و پیچیده کاربرد بیشتری دارند.
اگر با موضوعات فنی سئو آشنا نیستید، نگران نباشید؛ ابتدا مفهوم Crawl Budget را ساده توضیح میدهیم و سپس به سراغ بخشهای فنیتر میرویم.
بودجه خزش چیست؟
بودجه خزش (Crawl Budget) به مجموعه URLهایی گفته میشود که گوگل در یک سایت میتواند و میخواهد آنها را در یک بازه زمانی مشخص Crawl کند.
این تعریف یک نکته مهم دارد: Crawl Budget صرفاً به معنی «تعداد صفحاتی که گوگل در روز میخزد» نیست. گوگل برای تعیین نحوه خزش یک سایت، هم ظرفیت خزش سایت را در نظر میگیرد و هم نیاز یا تقاضای خزش را.
به زبان ساده، دو سؤال مطرح است:
- سرور و زیرساخت سایت چقدر توان پاسخگویی به درخواستهای خزنده را دارد؟
- گوگل تا چه اندازه نیاز دارد صفحات سایت را Crawl یا دوباره Crawl کند؟
بنابراین نباید Crawl Budget را یک عدد ثابت و از پیش تعیینشده برای همه سایتها تصور کرد. ظرفیت خزش میتواند با وضعیت سرور تغییر کند و تقاضای خزش نیز به عواملی مانند اندازه سایت، تازگی و تغییرات محتوا و اهمیت URLها وابسته است.
آیا همه سایتها باید نگران Crawl Budget باشند؟
خیر. این یکی از مهمترین نکاتی است که باید قبل از شروع بهینهسازی Crawl Budget بدانید.
راهنمای فعلی گوگل، مدیریت تخصصی Crawl Budget را بیشتر برای سایتهای بسیار بزرگ، سایتهایی با تغییرات زیاد و سایتهایی که تعداد بسیار زیادی URL دارند مطرح میکند. گوگل در این راهنما بهصورت تقریبی از سایتهای دارای بیش از ۱ میلیون صفحه یکتا با تغییرات نسبتاً منظم یا سایتهای دارای بیش از ۱۰ هزار صفحه یکتا با تغییرات بسیار سریع بهعنوان نمونههای مناسب برای این نوع بررسی نام میبرد. این اعداد آستانه قطعی نیستند و صرفاً برای درک مقیاس سایت ارائه شدهاند.
بنابراین اگر یک سایت شرکتی با ۳۰، ۱۰۰ یا حتی چند صد صفحه دارید، معمولاً نباید اولین فرض شما این باشد که ایندکس نشدن یک صفحه به دلیل کمبود Crawl Budget است.
در سایتهای کوچک و متوسط، بهتر است ابتدا مواردی مانند کیفیت محتوا، لینکهای داخلی، Canonical، Sitemap، وضعیت HTTP، Noindex و قابلیت دسترسی URL را بررسی کنید.
در مقابل، Crawl Budget در شرایط زیر اهمیت بیشتری پیدا میکند:
- فروشگاههای اینترنتی بسیار بزرگ
- مارکتپلیسها و سایتهای آگهی
- سایتهای خبری با حجم بسیار زیاد URL
- سایتهایی با فیلترهای متعدد و Faceted Navigation
- سایتهایی با URLهای پارامتری فراوان
- سایتهایی با صدها هزار یا میلیونها URL
- سایتهایی که بخش قابل توجهی از URLهای شناختهشده آنها در عمل ارزش مستقلی ندارند
Crawl Budget چگونه تعیین میشود؟
برای درک بهتر بودجه خزش، دو مفهوم اصلی را باید بشناسید:
۱. Crawl Capacity یا ظرفیت خزش
Crawl Capacity Limit به محدودیتی مربوط است که برای جلوگیری از وارد شدن فشار بیش از حد به سرور سایت وجود دارد.
گوگل برای تعیین ظرفیت خزش به وضعیت پاسخگویی سایت توجه میکند. اگر سرور بهصورت پایدار و سریع پاسخ دهد، شرایط مناسبتری برای خزش فراهم میشود. در مقابل، افزایش زمان پاسخ، خطاهای مکرر 5xx یا برخی خطاهای مرتبط با محدودیت درخواست میتوانند باعث کاهش سرعت خزش شوند.
این موضوع به این معنی نیست که با خرید سرور قویتر، گوگل بهصورت قطعی تعداد مشخصی URL بیشتر را Crawl خواهد کرد. ظرفیت سرور فقط یکی از بخشهای معادله Crawl Budget است.
۲. Crawl Demand یا تقاضای خزش
Crawl Demand به میزان نیازی مربوط است که گوگل برای Crawl کردن URLهای یک سایت دارد.
اندازه سایت، میزان تغییر محتوا، تازگی صفحات و اهمیت URLها میتوانند در این موضوع نقش داشته باشند. صفحهای که مرتباً تغییر میکند ممکن است نیاز به Crawl مجدد بیشتری نسبت به صفحهای داشته باشد که مدتها بدون تغییر مانده است.
در نتیجه میتوان مفهوم Crawl Budget را به شکل ساده اینگونه در نظر گرفت:
Crawl Budget = تعامل میان ظرفیت خزش و تقاضای خزش
Googlebot چگونه سایت را Crawl میکند؟
Googlebot برای پیدا کردن URLها از منابع مختلفی مانند لینکهای موجود در صفحات و نقشه سایت استفاده میکند. پس از کشف URL، گوگل میتواند آن را درخواست کرده و در صورت نیاز مراحل پردازش و رندر را انجام دهد.
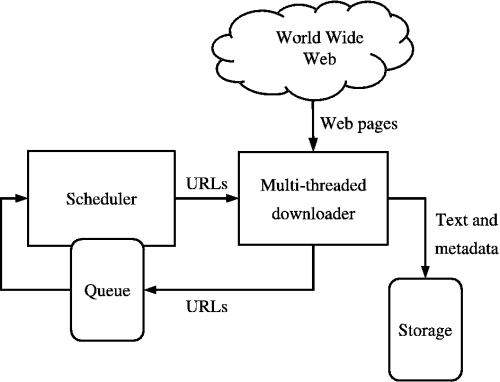
به همین دلیل ساختار لینک داخلی، Sitemap، معماری URL و نحوه تولید صفحات در سایت میتوانند روی تعداد URLهایی که Googlebot با آنها مواجه میشود اثر بگذارند.
منبع تصویر در Wikimedia Commons
تفاوت Crawl، Index و Ranking چیست؟
یکی از رایجترین اشتباهات در بحث بودجه خزش، یکی دانستن سه مرحله Crawl، Index و Ranking است.
Crawl
در این مرحله Googlebot URL را پیدا و درخواست میکند و محتوای آن را بررسی میکند.
Index
پس از Crawl، گوگل محتوا را پردازش و ارزیابی میکند و در صورت مناسب بودن، ممکن است آن را در Index قرار دهد.
Ranking
قرار گرفتن صفحه در ایندکس به معنی کسب رتبه برای همه جستجوها نیست. رتبهبندی مرحله دیگری است که در آن صفحه برای جستجوهای مختلف ارزیابی میشود.
Crawl شدن ≠ Index شدن ≠ رتبه گرفتن
بنابراین اگر صفحهای ایندکس نشده است، نباید بدون بررسی شواهد نتیجه بگیریم که Crawl Budget تمام شده است.
URLهای پارامتری و Faceted Navigation چگونه Crawl Budget را هدر میدهند؟
در سایتهای بزرگ، یکی از مهمترین مشکلات میتواند تولید تعداد زیادی URL از طریق فیلترها، مرتبسازیها و پارامترهای URL باشد.
/products?color=red
/products?color=blue
/products?size=small
/products?size=large
/products?brand=x
/products?brand=y
اگر ترکیب این فیلترها نیز URL جدید ایجاد کند، تعداد URLها میتواند بهصورت تصاعدی افزایش پیدا کند. در حالی که ممکن است بسیاری از این صفحات هیچ ارزش مستقلی برای جستجو نداشته باشند.
به همین دلیل در سایتهای فروشگاهی بزرگ باید مشخص شود کدام صفحات فیلترشده ارزش ایجاد و ایندکس شدن دارند و کدام ترکیبها صرفاً URLهای اضافی تولید میکنند.
راهکار صحیح همیشه «بستن همه فیلترها» نیست. ابتدا باید ارزش جستجوی هر گروه از URLها، رفتار کاربران، لینکهای داخلی و ساختار سایت بررسی شود.
صفحات تکراری چه مشکلی برای خزش ایجاد میکنند؟
فرض کنید چند URL تقریباً یک محتوا را ارائه میکنند:
example.com/product
example.com/product?sort=price
example.com/product?view=all
example.com/product?ref=123
اگر این URLها ارزش مستقلی نداشته باشند، بهتر است معماری سایت به شکلی طراحی شود که موتور جستجو با مجموعه بزرگی از URLهای مشابه و غیرضروری مواجه نشود.
بسته به شرایط، راهکار میتواند شامل اصلاح لینکهای داخلی، ادغام صفحات، مدیریت پارامترها، کنونیکال یا جلوگیری از Crawl برخی URLهای غیرضروری باشد.
Redirect Chain چه تأثیری بر خزش دارد؟
فرض کنید یک URL قدیمی ابتدا به URL دوم و سپس به URL سوم و چهارم Redirect شود:
A → B → C → Dدر چنین شرایطی خزنده برای رسیدن به مقصد نهایی باید چند مرحله را دنبال کند. بنابراین در صورت امکان بهتر است URLهای قدیمی مستقیماً به مقصد نهایی هدایت شوند:
A → Dمدیریت Redirectها فقط مسئله Crawl Budget نیست؛ ساختار سادهتر URLها، تجربه کاربر و نگهداری فنی سایت را نیز بهتر میکند.
خطاهای 5xx چه ارتباطی با Crawl Budget دارند؟
خطاهایی مانند 500، 502، 503 و 504 نشاندهنده مشکلاتی در پاسخگویی سرور هستند. اگر این خطاها بهصورت مکرر در هنگام درخواستهای خزنده رخ دهند، میتوانند روی ظرفیت خزش اثر منفی بگذارند.
در چنین شرایطی راهکار اصلی، پنهان کردن خطا از Googlebot نیست؛ بلکه باید مشکل زیرساختی پیدا و برطرف شود.
- بررسی مصرف CPU و RAM
- بررسی Queryهای سنگین دیتابیس
- بررسی محدودیتهای هاست
- بررسی Cache
- بررسی مشکلات PHP یا CMS
- بررسی DNS و شبکه
- بررسی افزایش ناگهانی بار سرور
404 و 410 چه نقشی در مدیریت Crawl دارند؟
همه URLهای 404 الزاماً نشانه مشکل Crawl Budget نیستند. ممکن است یک URL واقعاً حذف شده باشد و طبیعی باشد که Googlebot مدتی آن را دوباره بررسی کند.
اما اگر تعداد زیادی URL حذفشده همچنان از طریق لینکهای داخلی، Sitemap یا ساختارهای قدیمی سایت قابل کشف باشند، بهتر است منبع این URLها پیدا و اصلاح شود.
برای صفحاتی که واقعاً برای همیشه حذف شدهاند، استفاده درست از وضعیتهای 404 یا 410 میتواند به موتور جستجو در درک وضعیت URL کمک کند.
Sitemap چه ارتباطی با Crawl Budget دارد؟
Sitemap یکی از ابزارهای مهم برای معرفی URLهای سایت به موتورهای جستجو است؛ اما قرار گرفتن URL در نقشه سایت به معنی Crawl یا Index قطعی آن نیست.
یک Sitemap مناسب باید تا حد امکان تمیز باشد و URLهایی را شامل شود که واقعاً میخواهید موتور جستجو آنها را بشناسد و بررسی کند.
- URLهای معتبر
- URLهای اصلی و قابل ایندکس
- صفحات مهم و بهروز
- URLهایی که با Canonical به صفحه دیگری اشاره نمیکنند
قرار دادن تعداد زیادی URL دارای Redirect، 404 یا Noindex در Sitemap باعث نمیشود آن صفحات ارزش بیشتری پیدا کنند و بهتر است ساختار Sitemap بازبینی شود.
لینکسازی داخلی چه تأثیری بر Crawl دارد؟
لینک داخلی فقط برای انتقال سیگنالهای مرتبط با ساختار سایت استفاده نمیشود؛ این لینکها یکی از مسیرهای مهم کشف URLها نیز هستند.
صفحات مهم باید از بخشهای مرتبط سایت قابل دسترسی باشند و معماری لینکها نباید به شکلی باشد که تعداد زیادی URL کماهمیت را در اختیار خزنده قرار دهد.
برای آشنایی بیشتر با این موضوع میتوانید راهنمای لینک داخلی را نیز مطالعه کنید.
آیا robots.txt باعث افزایش Crawl Budget میشود؟
این سؤال پاسخ سادهای ندارد.
robots.txt ابزاری برای کنترل دسترسی خزنده به URLها و منابع خاص است. اگر URLهایی وجود دارند که واقعاً نمیخواهید Googlebot آنها را Crawl کند، در شرایط مناسب میتوان دسترسی به آنها را با robots.txt محدود کرد.
اما استفاده از robots.txt صرفاً با این تصور که «بودجه آزادشده را به صفحات مهم منتقل میکنیم» روش درستی نیست. گوگل صراحتاً توضیح میدهد که این ابزار برای جلوگیری از Crawl URLهای غیرضروری مناسب است، اما قرار نیست بهصورت موقت Crawl Budget آزادشده را به URLهای دیگر منتقل کند.
بنابراین robots.txt باید بر اساس معماری واقعی سایت تنظیم شود و نباید مسیرهای مهم سایت را بهصورت تصادفی مسدود کرد.
تفاوت robots.txt و noindex چیست؟
این دو دستور هدف یکسانی ندارند.
robots.txt درباره دسترسی خزنده به یک مسیر صحبت میکند؛ در حالی که noindex به موتور جستجو میگوید صفحه را در نتایج جستجو قرار ندهد.
برای مشاهده یک دستور noindex، خزنده باید بتواند صفحه را Crawl کند. بنابراین اگر همان URL را در robots.txt مسدود کنید، Googlebot ممکن است اصلاً نتواند محتوای صفحه و دستور noindex را ببیند.
به همین دلیل استفاده از این دو ابزار باید بر اساس هدف انجام شود، نه با این تصور که هر دو صرفاً برای «کاهش صفحات ایندکسشده» هستند.
برای URLهایی که واقعاً نمیخواهید Google آنها را Crawl کند، robots.txt میتواند مناسب باشد؛ اما برای تصمیمگیری درباره Index شدن یک صفحه، باید از ابزارهای مناسب همان هدف استفاده کنید.
آیا noindex باعث صرفهجویی در Crawl Budget میشود؟
نه به آن شکلی که معمولاً تصور میشود.
Googlebot برای دیدن noindex باید صفحه را درخواست کند. بنابراین اگر هزاران URL کمارزش را فقط با noindex علامتگذاری کنید، این URLها همچنان ممکن است بخشی از فرآیند Crawl را درگیر کنند.
اگر هدف اصلی شما جلوگیری از Crawl یک گروه مشخص از URLهای غیرضروری است، باید معماری URL و روش مدیریت خزش آنها را بررسی کنید؛ نه اینکه صرفاً روی noindex بهعنوان راهکار Crawl Budget حساب کنید.
آیا افزایش سرعت سایت باعث افزایش Crawl Budget میشود؟
افزایش سرعت سایت بهتنهایی به معنی افزایش قطعی Crawl Budget نیست.
اما سرعت و پایداری پاسخ سرور بخشی از ظرفیت خزش است. اگر سرور بتواند درخواستها را پایدارتر و با تأخیر کمتر پاسخ دهد، شرایط مناسبتری برای Crawl فراهم میشود.
به همین دلیل بررسی مواردی مانند Cache، دیتابیس، CPU، RAM، زمان پاسخ سرور، خطاهای 5xx و زیرساخت CDN در پروژههای بزرگ اهمیت پیدا میکند.
- زمان پاسخ سرور
- پایداری سرور
- خطاهای 5xx
- مصرف منابع
- Database Queryها
- Cache
- CDN
بنابراین بهینهسازی زیرساخت، هم برای کاربران و هم برای خزش بهتر سایت اهمیت دارد.
چگونه Crawl Budget سایت را بهینه کنیم؟
بهینهسازی Crawl Budget به معنی تلاش برای وادار کردن Googlebot به Crawl بیشتر نیست. هدف اصلی این است که منابع خزش موجود تا حد امکان صرف URLهایی شوند که واقعاً برای سایت اهمیت دارند.
۱. URLهای غیرضروری را شناسایی کنید
ابتدا باید بدانید سایت شما چه URLهایی تولید میکند. URLهای فیلتر، پارامتری، صفحات جستجوی داخلی، نسخههای تکراری و URLهای قدیمی میتوانند بخش قابل توجهی از این فهرست را تشکیل دهند.
۲. معماری URL را کنترل کنید
از تولید URLهایی که ارزش مستقل ندارند جلوگیری کنید. هر قابلیت فنی مانند فیلتر، مرتبسازی یا پارامتر نباید بهصورت خودکار باعث ایجاد هزاران URL قابل کشف شود.
۳. Sitemap را تمیز نگه دارید
Sitemap را مرتب بررسی کنید و URLهای Redirect، 404، Noindex و URLهایی که Canonical آنها به صفحه دیگری اشاره میکند را بدون دلیل در آن نگه ندارید.
۴. لینکهای داخلی را هدفمند کنید
صفحات مهم باید از طریق لینکهای داخلی قابل کشف باشند و لینکدهی داخلی نباید به تولید انبوه URLهای کمارزش منجر شود.
۵. Redirect Chain را کاهش دهید
تا جای ممکن URLهای قدیمی را مستقیماً به مقصد نهایی هدایت کنید و از زنجیرههایی مانند A → B → C → D جلوگیری کنید.
۶. خطاهای سرور را برطرف کنید
اگر Crawl Stats افزایش 5xx یا مشکلات Host Status را نشان میدهد، قبل از هر اقدام دیگری وضعیت سرور و زیرساخت را بررسی کنید.
۷. صفحات واقعاً غیرضروری را مدیریت کنید
صفحات حذفشده، نسخههای تکراری، فیلترهای غیرضروری و URLهای آزمایشی باید بر اساس هدف واقعی آنها مدیریت شوند. حذف، ادغام، Canonical، noindex یا Block کردن هرکدام کاربرد متفاوتی دارد.
چگونه Crawl Budget را در Google Search Console بررسی کنیم؟
برای بررسی دادههای خزش در Search Console میتوانید وارد بخش:
Settings → Crawl Stats
شوید.
گزارش Crawl Stats اطلاعاتی درباره رفتار خزندههای گوگل در سایت ارائه میدهد و برای سایتهای بزرگ میتواند در پیدا کردن الگوهای غیرعادی بسیار مفید باشد.
Total Crawl Requests
این گزارش تعداد درخواستهای Crawl را در بازه مورد بررسی نشان میدهد. بالا بودن این عدد بهتنهایی نشانه مشکل نیست؛ سؤال مهمتر این است که Googlebot دقیقاً چه URLهایی را درخواست میکند.
Average Response Time
این شاخص برای بررسی روند پاسخگویی سرور به درخواستهای خزنده مفید است. افزایش قابل توجه آن میتواند ارزش بررسی زیرساخت را داشته باشد، اما یک عدد منفرد نباید بدون درنظر گرفتن روند کلی و وضعیت سایت تفسیر شود.
Host Status
این بخش میتواند برای بررسی مشکلات دسترسی Google به سرور و وضعیت کلی ارتباط با سایت مورد استفاده قرار گیرد.
Crawl Responses
پاسخهایی مانند 200، 301، 302، 404 و 5xx را میتوان در این گزارش بررسی کرد تا مشخص شود Googlebot منابع خود را بیشتر روی چه نوع URLهایی مصرف میکند.
مثلاً اگر تعداد زیادی درخواست 404 مشاهده میکنید، سؤال مهم این است که چرا Googlebot همچنان این URLها را پیدا میکند. پاسخ ممکن است در لینکهای داخلی قدیمی، Sitemap، لینکهای خارجی یا ساختار URL سایت باشد.
Crawl Purpose
خزش را میتوان از نظر هدف نیز تحلیل کرد؛ برای مثال Googlebot ممکن است برای کشف URLهای جدید یا بررسی مجدد URLهای شناختهشده درخواست ارسال کند. بررسی این الگو در سایتهای بزرگ میتواند به تشخیص رفتار غیرعادی کمک کند.
یک مثال عملی از بهینهسازی Crawl Budget
فرض کنید یک فروشگاه اینترنتی دارای ۵۰ هزار محصول است، اما به دلیل فیلترهای مختلف حدود ۲ میلیون URL قابل تولید دارد.
/products?color=red
/products?color=blue
/products?size=small
/products?size=large
/products?brand=x
/products?brand=y
در این شرایط مسئله اصلی صرفاً زیاد بودن تعداد محصولات نیست. مشکل زمانی ایجاد میشود که میلیونها ترکیب فیلتر به URLهای قابل کشف تبدیل شوند، در حالی که بسیاری از آنها ارزش مستقلی برای جستجو ندارند.
در یک بررسی فنی میتوان این زنجیره را بررسی کرد:
URLهای تولیدشده → لینکهای قابل Crawl → Sitemap → وضعیت HTTP → Canonical → وضعیت Index → Crawl Stats
هدف این نیست که تمام فیلترها را کورکورانه مسدود کنیم. باید مشخص شود کدام فیلترها واقعاً نیاز کاربران را پاسخ میدهند و ارزش ایجاد یک URL مستقل را دارند و کدام ترکیبها فقط تعداد URLهای سایت را افزایش میدهند.
آیا افزایش تعداد مقالات باعث کاهش Crawl Budget میشود؟
نه لزوماً.
انتشار مقاله بیشتر بهخودیخود به معنی تمام شدن Crawl Budget نیست. اگر سایت ساختار سالمی داشته باشد، URLهای غیرضروری تولید نکند و صفحات مهم بهدرستی قابل کشف باشند، افزایش تعداد محتوا الزاماً مشکل Crawl ایجاد نمیکند.
مشکل زمانی جدیتر میشود که افزایش محتوا همراه با افزایش شدید URLهای تکراری، فیلترها، پارامترها، صفحات کمارزش یا خطاهای فنی باشد.
آیا Crawl Budget روی رتبه سایت تأثیر مستقیم دارد؟
نباید Crawl Budget را یک فاکتور مستقیم رتبهبندی تصور کرد.
بودجه خزش بیشتر درباره نحوه تخصیص منابع برای کشف و بررسی URLهاست. با این حال، اگر معماری یک سایت بزرگ باعث شود Googlebot بخش زیادی از زمان خود را صرف URLهای غیرضروری کند، ممکن است کشف یا بررسی مجدد صفحات مهم تحت تأثیر قرار بگیرد.
بنابراین ارتباط Crawl Budget با سئو بیشتر از جنس Technical SEO و قابلیت Crawl شدن مؤثر سایت است، نه یک سیگنال رتبهبندی مستقل.
چه سایتهایی بیشتر در معرض مشکلات Crawl Budget هستند؟
- فروشگاههای اینترنتی بزرگ با تعداد زیاد محصول و فیلتر
- مارکتپلیسها با URLهای بسیار زیاد
- سایتهای خبری با انتشار روزانه حجم بالای محتوا
- سایتهای دارای Faceted Navigation پیچیده
- سایتهای دارای URLهای پارامتری فراوان
- سایتهای دارای نسخههای تکراری متعدد از صفحات
- سایتهایی که Googlebot بخش زیادی از Crawl خود را روی URLهای غیرضروری مصرف میکند
اشتباهات رایج درباره Crawl Budget
وسواس روی Crawl Budget در سایت کوچک
اگر سایت شما چند ده یا چند صد صفحه دارد، معمولاً بهتر است ابتدا مشکلات بنیادی سئو را بررسی کنید و بدون مشاهده شواهد سراغ تحلیل پیچیده Crawl Budget نروید.
یکی دانستن Crawl و Index
Crawl شدن یک URL به معنی ایندکس شدن آن نیست. برای پیدا کردن دلیل ایندکس نشدن باید وضعیت URL، محتوا، Canonical، Noindex، دسترسی خزنده و سایر عوامل مرتبط را بررسی کرد.
مسدود کردن همه URLها با robots.txt
یک Disallow اشتباه میتواند دسترسی Googlebot به بخشهای مهم سایت را نیز مختل کند. robots.txt باید بر اساس ساختار واقعی سایت نوشته شود.
قرار دادن همه URLها در Sitemap
Sitemap محل معرفی URLهای مهم و معتبر است، نه فهرست تمام URLهایی که سایت قادر به تولید آنهاست.
تصور اینکه Crawl بیشتر همیشه بهتر است
هدف مدیریت Crawl Budget افزایش بیدلیل تعداد درخواستها نیست. هدف، Crawl کارآمدتر و هدایت بهتر موتور جستجو به سمت URLهای مهم است.
نادیده گرفتن مشکلات سرور
اگر سرور مرتباً خطا میدهد یا پاسخگویی مناسبی ندارد، اصلاح زیرساخت باید یکی از اولویتهای اصلی باشد.
چکلیست عملی بهینهسازی Crawl Budget
اگر سایت شما بزرگ و پیچیده است، میتوانید بررسی را با این چکلیست شروع کنید:
- URLهای تکراری و کمارزش را شناسایی کنید.
- URLهای پارامتری و فیلترها را بررسی کنید.
- Faceted Navigation را بر اساس ارزش واقعی صفحات مدیریت کنید.
- Sitemap را از URLهای غیرضروری پاک کنید.
- Redirect Chain را کاهش دهید.
- لینکهای داخلی شکسته و غیرضروری را اصلاح کنید.
- خطاهای 404 و 5xx را بررسی کنید.
- برای صفحات حذفشده دائمی، وضعیت مناسب 404 یا 410 را بررسی کنید.
- Canonicalها را با معماری واقعی سایت تطبیق دهید.
- robots.txt را از نظر Block شدن ناخواسته صفحات مهم بررسی کنید.
- وضعیت پاسخگویی سرور را بررسی کنید.
- گزارش Crawl Stats را در Search Console تحلیل کنید.
- URLهایی را که Googlebot بیشتر Crawl میکند با URLهای واقعاً مهم سایت مقایسه کنید.
- مشکل Crawl را با مشکل Indexing اشتباه نگیرید.
بودجه خزش چه ارتباطی با Technical SEO دارد؟
Crawl Budget یکی از موضوعات Technical SEO است، اما بهتنهایی وجود ندارد. برای مدیریت درست آن باید چند بخش سایت را در کنار هم دید:
- معماری سایت
- معماری URL
- لینکهای داخلی
- Sitemap
- robots.txt
- Canonical
- Redirectها
- وضعیت HTTP
- عملکرد سرور
- صفحات فیلتر و پارامتری
- کیفیت و یکتایی محتوا
به همین دلیل مدیریت Crawl Budget در سایتهای بزرگ معمولاً بخشی از یک فرآیند جامع Technical SEO است و نمیتوان آن را با یک تنظیم ساده در وردپرس یا Search Console حل کرد.
جمعبندی؛ بودجه خزش چیست؟
بودجه خزش یا Crawl Budget به مجموعه URLهایی مربوط میشود که گوگل در یک سایت میتواند و میخواهد آنها را Crawl کند. این مفهوم تحت تأثیر دو بخش اصلی یعنی Crawl Capacity و Crawl Demand قرار دارد.
مهمترین نکته این است که هر سایت لزوماً با مشکل Crawl Budget مواجه نیست. این موضوع بیشتر برای سایتهای بزرگ، پرتغییر و دارای تعداد بسیار زیاد URL اهمیت پیدا میکند.
در چنین سایتهایی باید بررسی شود که Googlebot منابع خود را دقیقاً روی چه URLهایی مصرف میکند. URLهای تکراری، صفحات فیلتر، پارامترهای غیرضروری، Redirect Chain، خطاهای سرور و ساختار ضعیف لینک داخلی میتوانند فرآیند خزش را پیچیدهتر کنند.
بنابراین هدف بهینهسازی Crawl Budget این نیست که صرفاً «خزش بیشتری» دریافت کنیم؛ بلکه باید کاری کنیم خزش سایت کارآمدتر شود و URLهای مهم راحتتر کشف و بررسی شوند.
اگر با یک سایت بزرگ روبهرو هستید، تحلیل Crawl Stats در کنار معماری URL، Sitemap، لینکهای داخلی، robots.txt و وضعیت سرور میتواند تصویر بسیار دقیقتری از مشکلات خزش در اختیار شما قرار دهد.
پرشیا وب در پروژههای طراحی سایت، سئو و پشتیبانی سایت نیز به همین نگاه فنی توجه دارد؛ زیرا سئو یک سایت بزرگ فقط به تولید محتوا و انتخاب کلمات کلیدی محدود نمیشود و معماری، زیرساخت و قابلیت Crawl شدن سایت نیز باید همزمان بررسی شوند.
سؤالات متداول درباره Crawl Budget
آیا Crawl Budget یک عدد ثابت است؟
خیر. نحوه خزش سایت به ظرفیت خزش و تقاضای خزش وابسته است و این شرایط میتواند با وضعیت سایت تغییر کند.
آیا سایت کوچک هم باید Crawl Budget را بهینه کند؟
معمولاً نه به شکل تخصصی. اگر سایت تعداد کمی صفحه دارد، بهتر است ابتدا مشکلات مهمتر مانند کیفیت محتوا، ساختار داخلی، Indexing، Sitemap و وضعیت فنی صفحات بررسی شود.
آیا Crawl شدن یک صفحه یعنی صفحه ایندکس شده است؟
خیر. Crawl، Index و Ranking مراحل متفاوتی هستند.
آیا سرعت سایت روی Crawl Budget تأثیر دارد؟
وضعیت پاسخگویی و ظرفیت سرور بخشی از Crawl Capacity است؛ بنابراین عملکرد ضعیف سرور و خطاهای مکرر میتوانند روی خزش اثر بگذارند، اما افزایش سرعت بهتنهایی افزایش قطعی Crawl Budget را تضمین نمیکند.
آیا robots.txt برای حذف صفحه از گوگل استفاده میشود؟
robots.txt برای کنترل Crawl است و نباید آن را با ابزارهای کنترل Index یکی دانست. اگر هدف شما جلوگیری از نمایش صفحه در نتایج است، باید از روش مناسب همان هدف استفاده کنید.
آیا noindex باعث کاهش Crawl میشود؟
Googlebot برای مشاهده noindex باید صفحه را درخواست کند؛ بنابراین noindex بهتنهایی راهکار کاهش Crawl برای URLهای غیرضروری نیست.
Crawl Stats را از کجا ببینیم؟
در Google Search Console از بخش Settings → Crawl Stats میتوانید دادههای مرتبط با خزش Googlebot را بررسی کنید. این گزارش برای تحلیل فنی سایتهای بزرگ کاربرد بیشتری دارد.
آیا افزایش تعداد مقالات باعث تمام شدن Crawl Budget میشود؟
خیر. افزایش تعداد مقالات بهتنهایی مشکل Crawl Budget ایجاد نمیکند. مسئله مهمتر تعداد و کیفیت URLهای قابل کشف و نحوه استفاده Googlebot از منابع خزش است.
