یکی از مشکلاتی که مدیران سایتها هنگام بررسی وضعیت فنی وبسایت در Google Search Console با آن مواجه میشوند، خطای Crawl یا مشکل خزیدن گوگل است. این خطاها نشان میدهند Googlebot هنگام پیدا کردن، دسترسی یا دریافت اطلاعات یک URL با مانعی روبهرو شده است. اگر این مشکل صفحات مهم سایت را درگیر کند، ممکن است فرایند ایندکس شدن محتوا یا بهروزرسانی اطلاعات آن در نتایج جستوجو مختل شود.
با این حال، خطای Crawl در سرچ کنسول نام یک خطای مشخص نیست. ممکن است گوگل هنگام مراجعه به یک صفحه با خطای 404 مواجه شود، سرور پاسخ 500 یا 503 بدهد، درخواست به دلیل Timeout کامل نشود، DNS دامنه مشکل داشته باشد یا یک ریدایرکت اشتباه مانع رسیدن ربات گوگل به مقصد شود. هرکدام از این وضعیتها علت و روش عیبیابی متفاوتی دارند.
بنابراین اگر در سرچ کنسول با خطای Crawl مواجه شدهاید، نباید بلافاصله تمام URLهای گزارششده را حذف کنید یا برای همه آنها ریدایرکت بسازید. ابتدا باید نوع خطا، اهمیت URL و علت ایجاد مشکل را مشخص کنید. در این راهنما، روش پیدا کردن خطاهای Crawl، تفسیر گزارشها و راهکار رفع مشکلات رایج را بهصورت مرحلهبهمرحله بررسی میکنیم.
خطای Crawl در سرچ کنسول چیست؟
Crawl یا خزش به فرایندی گفته میشود که در آن ربات گوگل به URLهای قابل کشف مراجعه میکند و تلاش میکند محتوای آنها را دریافت کند. اگر گوگل به دلیل مشکل سرور، محدودیت دسترسی، خطای DNS، پاسخ نامعتبر یا تنظیمات اشتباه نتواند صفحه را دریافت کند، ممکن است در گزارشهای سرچ کنسول اطلاعاتی درباره مشکل دسترسی یا خزیدن نمایش داده شود.
برای مثال، فرض کنید یک صفحه خدماتی مهم در سایت وردپرسی خود منتشر کردهاید. این صفحه در لینکهای داخلی و نقشه سایت قرار دارد، اما هنگام مراجعه Googlebot سرور پاسخ 503 میدهد. در چنین شرایطی، مشکل اصلی محتوای صفحه نیست؛ سرور نتوانسته درخواست ربات گوگل را بهدرستی پاسخ دهد. در مقابل، اگر گوگل صفحه را با موفقیت دریافت کند اما آن را ایندکس نکند، باید علت را در وضعیت ایندکس، محتوای صفحه، Canonical یا سایر عوامل مرتبط بررسی کنید.
نکته مهم این است که هر وضعیت غیرعادی در سرچ کنسول الزاماً به معنی وجود یک خطای فنی نیست. بعضی URLها عمداً حذف شدهاند، برخی صفحات تکراری هستند و بعضی محتواها نیز ممکن است پس از Crawl شدن، به دلایل مختلف وارد ایندکس نشوند. هدف از بررسی گزارشها، تشخیص وضعیت واقعی و اصلاح مواردی است که برای سایت اهمیت دارند.
تفاوت Crawl، Index و Ranking چیست؟
برای تشخیص درست مشکل، باید سه مرحله مهم در فرایند حضور صفحات در گوگل را از یکدیگر جدا کنید:
- Crawl یا خزش: گوگل URL را پیدا میکند و برای دریافت محتوای آن درخواست میفرستد.
- Index یا ایندکس: گوگل محتوای دریافتشده را پردازش میکند و در صورت مناسب بودن، آن را در ایندکس خود ذخیره میکند.
- Ranking یا رتبهبندی: گوگل صفحات واجد شرایط را برای جستوجوهای مختلف ارزیابی میکند و ممکن است آنها را در نتایج جستوجو نمایش دهد.
این مراحل به هم مرتبط هستند، اما یکسان نیستند. ممکن است گوگل هنوز صفحهای را Crawl نکرده باشد؛ ممکن است صفحه را Crawl کرده اما ایندکس نکرده باشد؛ یا ممکن است صفحه ایندکس شده باشد، ولی برای کلمه کلیدی موردنظر رتبه مناسبی نداشته باشد.
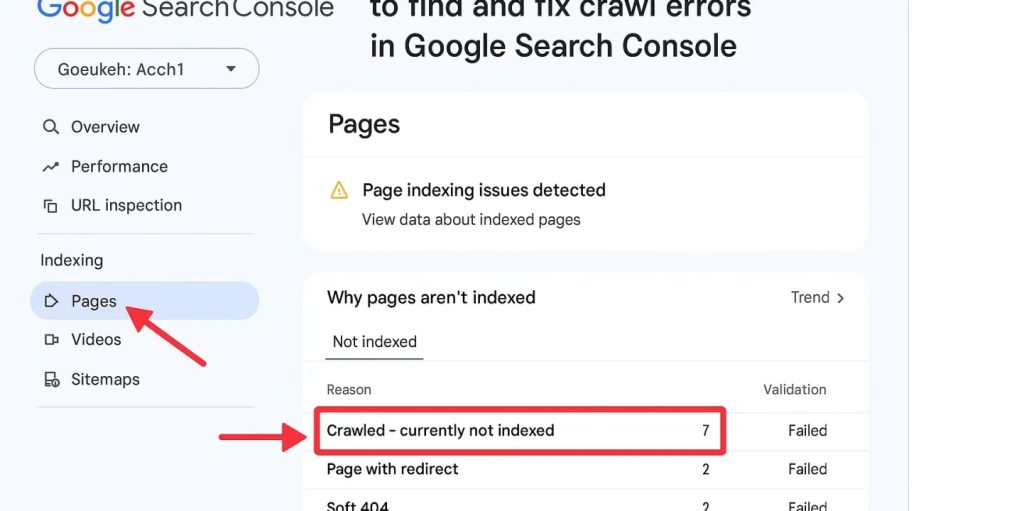
برای مثال، وضعیت Crawled – currently not indexed یعنی گوگل صفحه را خزیده است، اما در حال حاضر آن را ایندکس نکرده است. این وضعیت بهخودیخود به معنی شکست Crawl نیست. در چنین حالتی، علاوه بر بررسی وضعیت فنی صفحه، باید کیفیت و ارزش محتوایی، تکراری نبودن اطلاعات، لینکهای داخلی و انتخاب Canonical را نیز ارزیابی کنید.
برای آشنایی بیشتر با این مرحله میتوانید راهنمای ایندکس سایت چیست؟ را مطالعه کنید.
خطای Crawl را در کدام بخش سرچ کنسول پیدا کنیم؟
در نسخه فعلی Google Search Console، برای بررسی مشکلات خزیدن و ایندکس باید از چند ابزار استفاده کنید. انتخاب ابزار مناسب به این بستگی دارد که میخواهید یک URL را بررسی کنید یا وضعیت کلی سایت را تحلیل کنید.
۱. ابزار URL Inspection برای بررسی یک صفحه
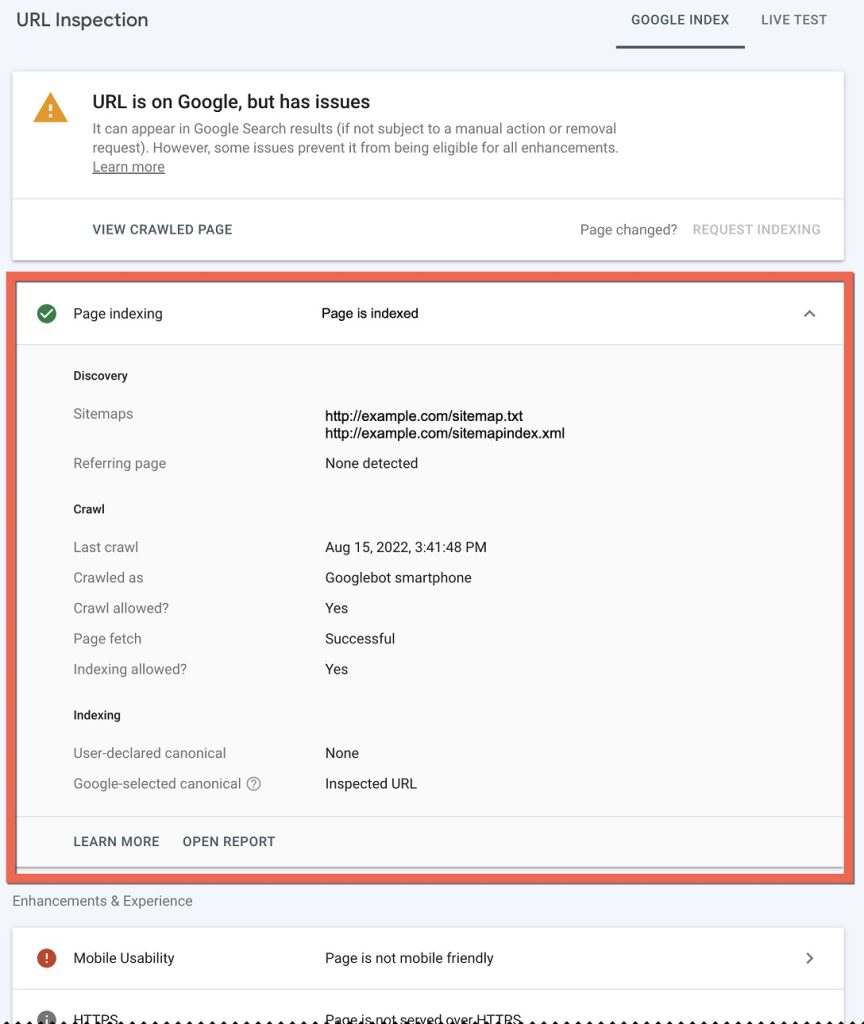
اگر یک URL مشخص در سرچ کنسول خطا دارد، از ابزار URL Inspection استفاده کنید. آدرس کامل صفحه را در نوار بالای Search Console وارد کنید. در گزارش ظاهرشده میتوانید وضعیت ایندکس، آخرین زمان Crawl، اجازه خزیدن، اجازه ایندکس شدن و اطلاعات Canonical را بررسی کنید. گزینه Test Live URL نیز امکان آزمایش وضعیت فعلی صفحه را فراهم میکند.
توجه کنید که نتیجه آزمایش زنده با اطلاعات ثبتشده از آخرین Crawl گوگل یکسان نیست. ممکن است مشکل از زمان آخرین بازدید گوگل برطرف شده باشد؛ بنابراین اگر گزارش قبلی خطا دارد اما تست زنده موفق است، تاریخ آخرین Crawl و جزئیات هر دو گزارش را مقایسه کنید.
۲. گزارش Page Indexing برای بررسی وضعیت صفحات
گزارش Page Indexing اطلاعاتی درباره URLهایی ارائه میدهد که گوگل از آنها مطلع شده و وضعیت ایندکس آنها را بررسی کرده است. در این گزارش، صفحات ایندکسشده و ایندکسنشده و علتهای مختلف ایندکس نشدن نمایش داده میشوند.
اگر تعداد زیادی از صفحات مهم سایت ایندکس نشدهاند یا تعداد URLهای دارای یک وضعیت خاص ناگهان افزایش یافته است، گزارش Page Indexing نقطه شروع مناسبی برای بررسی است. روی وضعیت موردنظر کلیک کنید تا نمونه URLهای درگیر و جزئیات بیشتری درباره علت مشکل ببینید.
این گزارش را نباید با یک فهرست از خطاهایی که همگی نیازمند اصلاح هستند اشتباه گرفت. برای مثال، URLهای حذفشده، صفحات تکراری یا آدرسهایی که عمداً نباید ایندکس شوند، ممکن است بهدرستی در گروه صفحات ایندکسنشده قرار بگیرند.
۳. گزارش Crawl Stats برای بررسی وضعیت خزیدن کل سایت
اگر مشکل محدود به یک URL نیست و احتمال میدهید کل سایت با اختلال دسترسی یا کندی سرور مواجه شده باشد، گزارش Crawl Stats را بررسی کنید. این گزارش در بخش تنظیمات Property سرچ کنسول قرار دارد و اطلاعاتی درباره درخواستهای خزیدن گوگل، کدهای پاسخ سرور، میانگین زمان پاسخگویی، حجم داده دریافتشده و وضعیت دسترسی Host ارائه میدهد.

برای نمونه، اگر پس از انتقال سایت به هاست جدید تعداد خطاهای سرور افزایش پیدا کرده باشد، بررسی نمودار Crawl Stats و زمان شروع مشکل میتواند به تشخیص ارتباط آن با تغییرات زیرساختی کمک کند. اگر مشکل در چند URL محدود است، بهتر است از URL Inspection و لاگ سرور برای بررسی دقیقتر استفاده کنید.
انواع خطای Crawl در سرچ کنسول و روش رفع آنها
نام و دستهبندی وضعیتها در سرچ کنسول ممکن است با توجه به گزارش و نوع مشکل متفاوت باشد. جدول زیر، رایجترین خطاهای مرتبط با دسترسی و خزیدن را بهصورت خلاصه نشان میدهد.
| نوع خطا یا وضعیت | معنی | اقدام اولیه |
|---|---|---|
| 404 Not Found | URL در سرور پیدا نشده است. | بررسی کنید صفحه باید وجود داشته باشد یا خیر. |
| 403 Forbidden | سرور دسترسی به URL را رد کرده است. | Firewall، افزونه امنیتی و محدودیت دسترسی را بررسی کنید. |
| 401 Unauthorized | دسترسی به منبع به احراز هویت نیاز دارد. | تنظیمات ورود و محافظت با رمز عبور را بررسی کنید. |
| Server Error (5xx) | سرور نتوانسته درخواست را بهدرستی پاسخ دهد. | لاگ سرور، منابع هاست و خطاهای PHP را بررسی کنید. |
| DNS Error | گوگل در برقراری ارتباط از طریق DNS مشکل داشته است. | رکوردهای DNS و وضعیت سرویسدهنده را بررسی کنید. |
| Timeout | پاسخ در زمان مناسب دریافت نشده است. | سرعت پاسخگویی، بار سرور و ارتباط شبکه را بررسی کنید. |
| Redirect Error | مسیر ریدایرکت مشکل دارد یا به مقصد نمیرسد. | زنجیره و حلقههای ریدایرکت را بررسی کنید. |
| Blocked by robots.txt | قوانین robots.txt خزیدن URL را محدود کردهاند. | بررسی کنید مسدودسازی عمدی است یا اشتباهی. |
| Crawled – currently not indexed | صفحه خزیده شده اما فعلاً ایندکس نشده است. | کیفیت محتوا، Canonical و نیاز واقعی به ایندکس را بررسی کنید. |
| Discovered – currently not indexed | گوگل URL را شناخته اما هنوز آن را Crawl نکرده است. | لینکهای داخلی، Sitemap و وضعیت سرور را بررسی کنید. |
در ادامه، مهمترین این وضعیتها و روش عیبیابی آنها را بررسی میکنیم. برای هر URL، ابتدا مشخص کنید آیا صفحه باید در دسترس و قابل ایندکس باشد؛ سپس متناسب با نوع خطا اقدام کنید.
خطای 404 در Crawl چیست و چگونه رفع میشود؟
خطای 404 Not Found زمانی رخ میدهد که سرور اعلام میکند URL درخواستی پیدا نشده است. برای مثال، فرض کنید قبلاً صفحه محصولی با آدرس زیر داشتهاید:
example.com/product/old-phone/اگر صفحه حذف شده باشد اما همچنان در لینکهای داخلی، Sitemap یا سایتهای دیگر به آن اشاره شود، ممکن است Googlebot دوباره به آن مراجعه کند و پاسخ 404 دریافت کند.
هر خطای 404 الزاماً مشکل سئو نیست. اگر صفحه عمداً حذف شده و جایگزین مناسبی ندارد، پاسخ 404 یا در صورت حذف دائمی و قطعی، 410 میتواند صحیح باشد. لازم نیست صرفاً برای کم کردن تعداد خطاهای سرچ کنسول، همه URLهای حذفشده را به صفحه اصلی هدایت کنید.
چه زمانی باید خطای 404 را اصلاح کنیم؟
- صفحه هنوز باید وجود داشته باشد اما به دلیل مشکل فنی باز نمیشود.
- URL در Sitemap قرار دارد، در حالی که صفحه حذف شده است.
- صفحات دیگر سایت به URL خراب لینک دادهاند.
- صفحه به آدرس جدیدی منتقل شده و باید ریدایرکت شود.
- URL قبلی بکلینکهای ارزشمند دارد و مقصد مرتبطی برای انتقال آن وجود دارد.
اگر محتوا به آدرس جدیدی منتقل شده است، معمولاً استفاده از ریدایرکت 301 به مقصد مرتبط مناسب است. اگر صفحه واقعاً حذف شده و جایگزین مناسبی ندارد، پاسخ 404 یا 410 را حفظ کنید. پس از اصلاح، لینکهای داخلی و Sitemap را نیز بهروزرسانی کنید.
خطای 5xx در سرچ کنسول چیست؟
کدهای وضعیت 5xx نشان میدهند سرور هنگام پاسخگویی به درخواست با مشکل مواجه شده است. نمونههای رایج عبارتاند از:
500 Internal Server Error
502 Bad Gateway
503 Service Unavailable
504 Gateway Timeout
این خطاها ممکن است به دلیل مصرف بیش از حد منابع هاست، خطای PHP، تداخل افزونهها، مشکل دیتابیس، تنظیمات اشتباه سرور، اختلال CDN یا افزایش ناگهانی درخواستها ایجاد شوند. اگر مشکل موقت باشد، ممکن است در تلاش بعدی برطرف شود؛ اما تکرار خطا در صفحات مهم یا افزایش گسترده آن در سایت نیازمند بررسی جدی است.
چگونه خطای 5xx را در وردپرس عیبیابی کنیم؟
- وضعیت سایت را بررسی کنید: URLهای درگیر را در مرورگر باز کنید و مشخص کنید خطا همچنان رخ میدهد یا فقط در گزارش قبلی ثبت شده است.
- لاگ سرور را ببینید: زمان خطا را با Error Log هاست مقایسه کنید تا علت احتمالی مشخص شود.
- منابع هاست را بررسی کنید: مصرف CPU، حافظه، تعداد پردازشهای PHP و محدودیتهای سرویس را بررسی کنید.
- تغییرات اخیر را مرور کنید: اگر خطا بعد از نصب افزونه، بهروزرسانی قالب یا تغییر تنظیمات شروع شده، همان تغییرات را بررسی کنید.
- از پشتیبانی هاست کمک بگیرید: اگر خطا در سطح سرور یا دیتابیس است، گزارش URL و زمان وقوع را برای بررسی ارسال کنید.
در وردپرس، غیرفعال کردن موقت افزونهها یا آزمایش قالب پیشفرض میتواند به شناسایی تداخل کمک کند؛ اما این کار را با احتیاط و ترجیحاً در محیط آزمایشی انجام دهید. اگر به لاگهای فنی دسترسی ندارید یا سایت کسبوکار را تحت تأثیر قرار داده است، بهتر است پیش از تغییرات گسترده از متخصص یا پشتیبانی هاست کمک بگیرید.
برای آشنایی بیشتر با یکی از خطاهای رایج سرور، مقاله خطای 500 Internal Server Error را مطالعه کنید.
خطای 403 در Crawl چیست؟
خطای 403 Forbidden یعنی سرور درخواست را دریافت کرده، اما اجازه دسترسی به منبع موردنظر را نداده است. در سایتهای وردپرسی، این وضعیت ممکن است به دلیل قوانین Firewall، افزونههای امنیتی، محدودیت IP، تنظیمات سرور، فایل .htaccess یا تنظیمات CDN ایجاد شود.
اگر یک صفحه باید عمومی باشد اما Googlebot با پاسخ 403 روبهرو میشود، ابتدا مشخص کنید کدام لایه درخواست را مسدود کرده است. لاگ فایروال یا افزونه امنیتی و گزارشهای سرور میتوانند در تشخیص علت کمک کنند. همچنین بررسی کنید آیا این محدودیت برای همه کاربران وجود دارد یا فقط درخواستهای خاص را درگیر میکند.
اگر مشکل بلافاصله پس از فعالسازی یک افزونه امنیتی یا تغییر قوانین ضدربات ایجاد شده است، زمان شروع خطا را با آن تغییر مقایسه کنید. البته صرف مشاهده خطای 403 به معنی مسدود شدن Googlebot توسط افزونه امنیتی نیست؛ علت باید با بررسی پاسخ سرور و گزارشهای مربوطه مشخص شود.
خطای 401 در سرچ کنسول چیست؟
کد 401 Unauthorized معمولاً نشان میدهد دسترسی به منبع به احراز هویت نیاز دارد. برای مثال، ممکن است صفحه پشت سیستم ورود کاربران، محافظت با رمز عبور یا تنظیمات دسترسی سرور قرار گرفته باشد.
اگر صفحه باید عمومی باشد، تنظیمات Password Protection، دسترسیهای سرور و افزونههایی را که ورود به سایت را اجباری میکنند بررسی کنید. اما اگر صفحه عمداً خصوصی است، پاسخ 401 الزاماً مشکلی نیست و نباید صرفاً برای ایندکس شدن آن، محدودیت امنیتی را حذف کنید.
خطای DNS در Crawl چیست؟
خطای DNS زمانی رخ میدهد که Googlebot نتواند از طریق سامانه نام دامنه به سرور موردنظر دسترسی پیدا کند. در این حالت، مشکل لزوماً از وردپرس یا محتوای صفحه نیست و ممکن است به تنظیمات دامنه یا سرویس DNS مربوط باشد.
موارد زیر را بررسی کنید:
- درست بودن رکوردهای DNS و Nameserverها
- اختلال احتمالی سرویسدهنده DNS
- تغییرات اخیر در دامنه یا تنظیمات هاست
- درست بودن مقصد رکوردهای مربوط به نسخههای مختلف دامنه
- وجود اختلال در دسترسی دامنه از شبکههای مختلف
اگر خطای DNS پس از انتقال هاست یا تغییر Nameserverها شروع شده است، تنظیمات دامنه را با اطلاعات ارائهشده از طرف سرویسدهنده مقایسه کنید. اگر مشکل فقط در گزارش گوگل دیده میشود، زمان وقوع و وضعیت Host در Crawl Stats را نیز بررسی کنید و فرض نکنید که باز شدن سایت در مرورگر شخصی، همه مشکلات دسترسی Googlebot را رد میکند.
خطای Timeout در Crawl چیست؟
در خطای Timeout، درخواست برای دریافت صفحه ارسال شده، اما پاسخ در زمان مناسب کامل نشده است. این مشکل ممکن است به دلیل کندی سرور، پردازشهای طولانی PHP، کوئریهای سنگین دیتابیس، مصرف بالای منابع، اختلال شبکه یا تنظیمات Timeout در CDN و Proxy ایجاد شود.
برای مثال، اگر یک فروشگاه اینترنتی هنگام اجرای گزارش سنگین یا پردازش تعداد زیادی سفارش با افت سرعت مواجه شود، ممکن است درخواستهای همزمان نیز با تأخیر پاسخ داده شوند. در چنین شرایطی، افزایش خطاهای Timeout میتواند نشانه محدودیت منابع یا مشکل در عملکرد زیرساخت باشد.
برای تشخیص علت، میانگین زمان پاسخ سرور در Crawl Stats را بررسی کنید، زمان ثبت خطا را با لاگهای سرور تطبیق دهید و صفحات کند یا پردازشهای سنگین را شناسایی کنید. افزایش منابع هاست تنها زمانی راهکار مناسبی است که شواهد نشان دهند منابع فعلی واقعاً به سقف ظرفیت خود رسیدهاند.
خطای Redirect در Crawl چگونه ایجاد میشود؟
ریدایرکت زمانی مشکلساز میشود که مسیر انتقال URL اشتباه باشد، به حلقه تبدیل شود یا گوگل نتواند به مقصد نهایی برسد. برای مثال، زنجیره زیر را در نظر بگیرید:
A → B → C → D → Eدر این حالت، درخواست باید چند مرحله را طی کند تا به مقصد نهایی برسد. مشکل جدیتر زمانی رخ میدهد که حلقه ایجاد شود:
A → B → Aدر حلقه Redirect، درخواست بین URLها جابهجا میشود و به مقصد نهایی نمیرسد. مقصد نامعتبر، زنجیره طولانی یا ترکیب اشتباه HTTP و HTTPS نیز میتواند به مشکلات دسترسی منجر شود.
روش رفع Redirect Error
- مسیر کامل انتقال URL قدیمی تا مقصد نهایی را بررسی کنید.
- حلقههای Redirect را حذف کنید.
- در صورت امکان، URL قدیمی را مستقیماً به مقصد نهایی مرتبط هدایت کنید.
- مطمئن شوید مقصد نهایی وجود دارد و پاسخ مناسب میدهد.
- لینکهای داخلی و Sitemap را به URL نهایی بهروزرسانی کنید.
اگر اخیراً ساختار URL یا تنظیمات HTTPS سایت را تغییر دادهاید، قوانین ریدایرکت را با دقت بررسی کنید. همچنین برای آشنایی با انواع انتقال URL، راهنمای ریدایرکت چیست؟ میتواند مفید باشد.
Blocked by robots.txt یعنی چه؟
اگر سرچ کنسول نشان دهد URL توسط robots.txt مسدود شده است، یعنی قوانین این فایل به Googlebot اجازه خزیدن در آن مسیر را نمیدهند. برای مثال، قانون زیر دسترسی خزندهها به مسیر /private/ را محدود میکند:
User-agent: *
Disallow: /private/
اگر این محدودیت عمدی باشد، ممکن است هیچ اقدامی لازم نباشد. اما اگر یک صفحه مهم باید توسط گوگل Crawl شود، قوانین فایل را بررسی کنید تا مطمئن شوید URL یا مسیر آن بهصورت ناخواسته مسدود نشده است.
نکته مهم: robots.txt ابزار اصلی حذف URL از نتایج جستوجو نیست. این فایل برای کنترل خزش استفاده میشود. اگر هدف جلوگیری از ایندکس شدن یک صفحه است، باید روش مناسب را با توجه به شرایط آن انتخاب کنید؛ برای مثال، استفاده از دستور noindex مستلزم آن است که گوگل بتواند صفحه را Crawl کند و دستور را ببیند. اگر صفحه را در robots.txt مسدود کرده باشید، گوگل ممکن است نتواند دستور noindex را دریافت کند.
تفاوت خطای robots.txt با خطای سرور چیست؟
اگر فایل robots.txt با موفقیت در دسترس باشد، گوگل میتواند قوانین آن را دریافت کند. اما اگر Googlebot نتواند این فایل را به دلیل خطای سرور، DNS یا Timeout دریافت کند، وضعیت متفاوت است و ممکن است خزیدن سایت موقتاً محدود شود.
به همین دلیل، هنگام افت ناگهانی Crawl فقط محتوای فایل robots.txt را بررسی نکنید؛ کد پاسخ خود فایل را نیز بررسی کنید. آدرس زیر را در مرورگر باز کنید و مطمئن شوید فایل بهدرستی در دسترس است:
https://example.com/robots.txtبه جای example.com دامنه سایت خود را قرار دهید. سپس بررسی کنید آیا مسیرهای مهم به اشتباه مسدود شدهاند یا خیر و در صورت مشاهده خطای دسترسی، تنظیمات سرور و DNS را نیز بررسی کنید.
آیا Crawled – currently not indexed یک خطای Crawl است؟
خیر. این وضعیت به این معنی است که گوگل صفحه را Crawl کرده، اما در حال حاضر آن را وارد ایندکس نکرده است. بنابراین در چنین شرایطی، صرفاً افزایش سرعت سرور یا درخواست ایندکس مجدد لزوماً مشکل را حل نمیکند.
برای بررسی این وضعیت، موارد زیر را ارزیابی کنید:
- کیفیت و ارزش محتوا: آیا صفحه پاسخ کامل و مفیدی به نیاز کاربر میدهد یا اطلاعات آن سطحی و تکراری است؟
- محتوای مشابه: آیا صفحات متعددی با موضوع و اطلاعات تقریباً یکسان در سایت وجود دارند؟
- Canonical: آیا گوگل URL دیگری را بهعنوان نسخه اصلی محتوا انتخاب کرده است؟
- لینکسازی داخلی: آیا صفحه از صفحات مرتبط سایت لینک دریافت میکند؟
- وضعیت فنی: آیا صفحه پاسخ HTTP مناسبی دارد و بهاشتباه با noindex مسدود نشده است؟
اگر صفحه از نظر فنی در دسترس است اما ایندکس نمیشود، ابتدا دلیل وضعیت آن را در URL Inspection و Page Indexing بررسی کنید. سپس بر اساس علت احتمالی، محتوا و ساختار سایت را اصلاح کنید. برای آشنایی بیشتر با نحوه انتخاب نسخه اصلی صفحات، مقاله تگ Canonical چیست؟ را مطالعه کنید.
Discovered – currently not indexed چه تفاوتی با خطای Crawl دارد؟
در وضعیت Discovered – currently not indexed، گوگل از وجود URL مطلع شده، اما هنوز آن را Crawl نکرده است. این وضعیت با Crawled – currently not indexed تفاوت دارد؛ در حالت دوم، صفحه خزیده شده اما ایندکس نشده است.
اگر تعداد زیادی از صفحات مهم در وضعیت Discovered باقی ماندهاند، ابتدا بررسی کنید که URLها از طریق لینکهای داخلی قابل کشف باشند و در صورت نیاز در Sitemap معتبر قرار گرفته باشند. سپس وضعیت پاسخگویی سرور، تعداد URLهای کمارزش یا تکراری و روند خزیدن در Crawl Stats را بررسی کنید.
وجود این وضعیت بهتنهایی ثابت نمیکند که سایت با مشکل Crawl Budget روبهرو شده است. برای تشخیص علت، باید اندازه سایت، تعداد صفحات جدید، ساختار لینکسازی، کیفیت URLهای کشفشده و ظرفیت پاسخگویی سرور را در کنار هم بررسی کنید.
چگونه با URL Inspection خطای Crawl را بررسی کنیم؟
برای بررسی دقیق یک صفحه، URL آن را در نوار بالای سرچ کنسول وارد کنید. سپس اطلاعات زیر را بررسی کنید:
- Page availability یا Page fetch: آیا گوگل توانسته صفحه را دریافت کند؟
- Crawl allowed: آیا قوانین robots.txt اجازه خزیدن را میدهند؟
- Indexing allowed: آیا صفحه اجازه ایندکس شدن دارد؟
- Last crawl: آخرین بار چه زمانی گوگل صفحه را Crawl کرده است؟
- User-declared canonical و Google-selected canonical: آیا نسخهای که سایت معرفی کرده با نسخه انتخابی گوگل مطابقت دارد؟
پس از بررسی گزارش ثبتشده، گزینه Test Live URL را اجرا کنید. این آزمایش وضعیت فعلی دسترسی صفحه را بررسی میکند، اما جایگزین همه بررسیهای ایندکس نیست؛ برای مثال، برخی تصمیمهای مربوط به Canonical یا وضعیت ثبتشده در ایندکس ممکن است در تست زنده به همان شکل ارزیابی نشوند.
اگر مشکل را برطرف کردهاید و تست زنده موفق است، میتوانید برای یک URL مهم از گزینه Request Indexing استفاده کنید. این درخواست تضمین نمیکند که صفحه فوراً یا حتماً ایندکس شود. برای تعداد زیادی URL، بهروزرسانی Sitemap معمولاً روش مناسبتری برای معرفی صفحات است.
نقش Sitemap در رفع مشکلات Crawl چیست؟
نقشه سایت یا Sitemap به گوگل کمک میکند URLهای مهم را کشف کند؛ اما ثبت URL در Sitemap به معنی Crawl یا ایندکس قطعی آن نیست. Sitemap باید شامل URLهای معتبر و موردنظر شما برای حضور در نتایج جستوجو باشد.
اگر صفحهای حذف شده یا به آدرس دیگری منتقل شده است، Sitemap را نیز متناسب با وضعیت جدید بهروزرسانی کنید. برای مثال، اگر URL قدیمی زیر حذف شده است:
/product/old-product/و نسخه جدید محتوا در آدرس زیر قرار دارد:
/product/new-product/در صورت مرتبط بودن دو صفحه، URL قدیمی را بهدرستی ریدایرکت کنید و URL جدید را در Sitemap نگه دارید. همچنین لینکهای داخلی را اصلاح کنید تا مستقیماً به مقصد نهایی اشاره کنند.
آیا حذف URL از سرچ کنسول خطای Crawl را برطرف میکند؟
خیر. حذف یا پنهان کردن یک URL از یک گزارش یا ابزار، لزوماً مشکل فنی آن را حل نمیکند. راه درست این است که وضعیت واقعی صفحه را مشخص کنید و بر اساس آن تصمیم بگیرید:
- صفحه باید وجود داشته باشد: علت خطا را پیدا کنید و دسترسی یا محتوای صفحه را اصلاح کنید.
- صفحه منتقل شده است: در صورت وجود مقصد مرتبط، ریدایرکت مناسب تنظیم کنید.
- صفحه برای همیشه حذف شده است: در نبود جایگزین مناسب، پاسخ 404 یا 410 را حفظ کنید.
- صفحه نباید ایندکس شود: از روش مناسب برای کنترل ایندکس استفاده کنید و آن را با مسدودسازی Crawl اشتباه نگیرید.
برای مثال، اگر صفحهای به اشتباه حذف شده باشد، بهترین اقدام بازگرداندن آن است؛ نه اینکه صرفاً از ابزارهای سرچ کنسول برای مخفی کردن URL استفاده کنید.
چرا پس از رفع خطا، هنوز گزارش Crawl Error نمایش داده میشود؟
سرچ کنسول همیشه وضعیت لحظهای سایت را در همه گزارشها نمایش نمیدهد. ممکن است خطا در آخرین Crawl ثبت شده باشد، اما شما بعداً مشکل را برطرف کرده باشید. در این حالت، گزارش قبلی میتواند تا زمان بهروزرسانی اطلاعات همچنان خطا را نشان دهد.
برای بررسی، URL را با Test Live URL آزمایش کنید و نتیجه را با تاریخ آخرین Crawl مقایسه کنید. اگر تست فعلی موفق است، اما گزارش قبلی همچنان خطا دارد، ممکن است لازم باشد برای بهروزرسانی گزارش و Crawl بعدی گوگل زمان بدهید.
هدف، صفر کردن فوری تعداد خطاها در سرچ کنسول نیست؛ هدف این است که علت خطاهای مهم برطرف شود و URLها وضعیت فنی درستی داشته باشند.
اگر خطای Crawl ناگهان افزایش پیدا کرد، چه کنیم؟
افزایش ناگهانی خطاها میتواند نشانه تغییر در زیرساخت یا تنظیمات سایت باشد. ابتدا زمان شروع مشکل را مشخص کنید و ببینید آیا در همان بازه تغییر مهمی انجام دادهاید یا خیر.
- انتقال سایت به هاست جدید
- تغییر DNS یا Nameserver
- فعالسازی یا تغییر تنظیمات CDN
- تغییر قالب یا افزونههای وردپرس
- تغییر تنظیمات Firewall یا افزونه امنیتی
- تغییر ساختار URLها
- تغییر قوانین Redirect
- تغییر فایل robots.txt
- افزایش ناگهانی ترافیک یا مصرف منابع سرور
سپس در Crawl Stats بررسی کنید افزایش خطا بیشتر مربوط به کدام نوع پاسخ است. اگر خطاهای 5xx و مشکلات دسترسی Host افزایش یافتهاند، وضعیت سرور و لاگها را بررسی کنید. اگر بیشتر URLها 404 هستند، تغییرات URL، لینکهای داخلی و Sitemap را ارزیابی کنید. اگر مشکل پس از تغییر Firewall شروع شده است، قوانین دسترسی را بررسی کنید.
بهتر است به جای اصلاح تصادفی صفحات، ابتدا یک الگوی مشترک بین URLهای درگیر پیدا کنید. ممکن است چند صد URL گزارششده، همگی از یک تنظیم اشتباه یا یک مشکل زیرساختی مشترک تأثیر گرفته باشند.
آیا همه خطاهای Crawl به سئو آسیب میزنند؟
خیر. اهمیت خطا به نوع آن، وضعیت واقعی URL و نقش صفحه در سایت بستگی دارد. چند URL قدیمی که عمداً حذف شدهاند و پاسخ 404 صحیح میدهند، لزوماً نشانه مشکل جدی سئو نیستند. اما اگر صفحه اصلی، صفحات خدماتی مهم، دستهبندیهای اصلی یا تعداد زیادی از URLهای ارزشمند با خطای 5xx مواجه شوند، باید موضوع را در اولویت قرار دهید.
برای تعیین اولویت اصلاح، این چهار سؤال را از خود بپرسید:
۱. آیا URL باید وجود داشته باشد؟
اگر صفحه عمداً حذف شده و جایگزین مناسبی ندارد، ممکن است نیازی به اقدام نباشد. اگر صفحه مهمی است که باید در دسترس باشد، علت خطا را پیدا کنید.
۲. آیا URL در Sitemap قرار دارد؟
اگر URL حذفشده هنوز در نقشه سایت است، آن را اصلاح کنید. همچنین مطمئن شوید URLهای مهم و معتبر در Sitemap حضور دارند.
۳. آیا صفحات دیگر سایت به URL لینک میدهند؟
لینکهای داخلی خراب را اصلاح کنید و در صورت انتقال محتوا، لینکها را مستقیماً به مقصد نهایی تغییر دهید.
۴. آیا URL برای کسبوکار اهمیت دارد؟
خطای یک صفحه فرعی و قدیمی با خطای صفحه خدمات اصلی یا محصول پرفروش یکسان نیست. ابتدا URLهایی را بررسی کنید که برای کاربران، تبدیل مشتری یا ورودی ارگانیک اهمیت بیشتری دارند.
روش سریع عیبیابی Crawl Error در وردپرس
اگر سایت شما با وردپرس ساخته شده است، مراحل زیر میتواند مسیر بررسی را منظمتر کند:
- مرحله اول: URL مشکلدار را در URL Inspection وارد کنید.
- مرحله دوم: وضعیت فعلی صفحه را با Test Live URL بررسی کنید.
- مرحله سوم: نوع دقیق خطا و کد پاسخ HTTP را مشخص کنید.
- مرحله چهارم: اگر خطا 404 است، بررسی کنید صفحه باید وجود داشته باشد یا حذف شده است.
- مرحله پنجم: اگر خطا 5xx است، Error Log، منابع هاست، PHP و وضعیت دیتابیس را بررسی کنید.
- مرحله ششم: اگر خطا 403 یا 401 است، قوانین Firewall، افزونههای امنیتی و محدودیتهای دسترسی را بررسی کنید.
- مرحله هفتم: اگر خطای Redirect دارید، زنجیره انتقال، حلقهها و مقصد نهایی را بررسی کنید.
- مرحله هشتم: اگر مشکل مربوط به robots.txt است، قوانین و کد پاسخ فایل را بررسی کنید.
- مرحله نهم: اگر خطا DNS یا Timeout است، وضعیت سرویس DNS، سرور و شبکه را بررسی کنید.
- مرحله دهم: پس از اصلاح، تست زنده را تکرار کنید و در صورت نیاز برای URLهای مهم درخواست ایندکس ثبت کنید.
در صورت مشاهده خطاهای گسترده سرور یا مشکلاتی که به تنظیمات زیرساخت مربوط هستند، از تغییرات آزمایشی روی سایت فعال خودداری کنید. ابتدا نسخه پشتیبان تهیه کنید و در صورت امکان، عیبیابی افزونهها و قالب را در محیط آزمایشی انجام دهید.
اشتباهات رایج هنگام رفع خطای Crawl
تلاش برای رفع تمام خطاهای 404
تمام URLهای 404 نیازمند ریدایرکت یا بازسازی نیستند. اگر صفحه عمداً حذف شده و جایگزین مناسبی ندارد، پاسخ 404 یا 410 میتواند درست باشد.
ریدایرکت کردن تمام URLهای خراب به صفحه اصلی
این کار برای URLهایی که ارتباطی با صفحه اصلی ندارند، معمولاً راهکار مناسبی نیست و ممکن است باعث تشخیص Soft 404 شود. مقصد ریدایرکت باید تا حد امکان با محتوای قبلی مرتبط باشد.
استفاده از robots.txt برای حذف صفحه از ایندکس
robots.txt برای کنترل Crawl است و بهتنهایی تضمین نمیکند URL از نتایج جستوجو حذف شود. برای کنترل ایندکس باید از روش متناسب با وضعیت صفحه استفاده کنید.
ارسال درخواست ایندکس برای تمام URLها
Request Indexing تضمینکننده ایندکس شدن نیست و برای ارسال نامحدود درخواست طراحی نشده است. پس از رفع واقعی مشکل، این گزینه را برای صفحات مهم استفاده کنید و برای معرفی تعداد زیادی URL از Sitemap کمک بگیرید.
نادیده گرفتن خطاهای 5xx و مشکلات دسترسی
خطاهای موقت ممکن است بدون اقدام خاصی برطرف شوند، اما تکرار خطاهای سرور یا غیرقابلدسترس شدن تعداد زیادی از صفحات مهم نیازمند بررسی فوری است.
تغییر همزمان چند تنظیم بدون ثبت نتیجه
اگر همزمان افزونهها، تنظیمات سرور، فایل robots.txt و Redirectها را تغییر دهید، تشخیص عامل اصلی دشوارتر میشود. بهتر است هر تغییر را مستند کنید و پس از هر مرحله، وضعیت URLهای نمونه را دوباره آزمایش کنید.
چکلیست نهایی رفع خطای Crawl در سرچ کنسول
پیش از بستن گزارش یا اعلام رفع مشکل، این موارد را بررسی کنید:
- URL مشکلدار را در URL Inspection بررسی کردهام.
- نوع خطا و کد پاسخ HTTP را مشخص کردهام.
- بررسی کردهام که URL باید وجود داشته باشد یا خیر.
- لینکهای داخلی و Sitemap را بررسی کردهام.
- Redirectها و مقصد نهایی را بررسی کردهام.
- قوانین robots.txt و وضعیت noindex را بررسی کردهام.
- Canonical اعلامشده و Canonical انتخابی گوگل را مقایسه کردهام.
- در خطاهای 5xx، منابع هاست و لاگهای سرور را بررسی کردهام.
- در خطاهای 403 و 401، محدودیتهای دسترسی و تنظیمات امنیتی را بررسی کردهام.
- در خطاهای DNS و Timeout، وضعیت زیرساخت را بررسی کردهام.
- پس از اصلاح، تست زنده URL را اجرا کردهام.
- برای صفحات مهم، در صورت نیاز درخواست ایندکس ثبت کردهام.
- در روزهای بعد، گزارشهای مرتبط را دوباره بررسی خواهم کرد.
سؤالات متداول درباره خطای Crawl در سرچ کنسول
آیا خطای Crawl به معنی ایندکس نشدن صفحه است؟
نه همیشه. بعضی خطاهای دسترسی مانع دریافت صفحه میشوند و میتوانند ایندکس شدن آن را مختل کنند؛ اما وضعیتهای مرتبط با Crawl و Index یکسان نیستند. برای بررسی هر URL، گزارش URL Inspection و علت دقیق وضعیت را ببینید.
آیا تمام خطاهای Crawl باید رفع شوند؟
خیر. ابتدا اهمیت URL و علت خطا را مشخص کنید. برای مثال، 404 مربوط به صفحهای که عمداً حذف شده و جایگزین ندارد، ممکن است کاملاً صحیح باشد؛ اما خطای سرور در صفحه خدمات اصلی نیازمند بررسی است.
بعد از رفع خطای Crawl چه زمانی گزارش بهروزرسانی میشود؟
زمان مشخصی برای همه سایتها وجود ندارد. گزارشها پس از بررسی مجدد گوگل بهروزرسانی میشوند و ممکن است مدتی طول بکشد. تست زنده URL میتواند وضعیت فعلی دسترسی را بررسی کند، اما لزوماً همه گزارشهای ایندکس را فوراً تغییر نمیدهد.
آیا Request Indexing مشکل Crawl را برطرف میکند؟
خیر. ابتدا باید علت فنی خطا را برطرف کنید. Request Indexing فقط امکان ارسال درخواست بررسی مجدد URL را فراهم میکند و تضمینی برای ایندکس شدن صفحه نیست.
اگر تعداد خطاهای Crawl ناگهان افزایش یابد، اولین اقدام چیست؟
ابتدا نوع خطاها و زمان شروع افزایش آنها را بررسی کنید. سپس تغییرات اخیر سایت، وضعیت Crawl Stats، پاسخ سرور و URLهای درگیر را مقایسه کنید. پیدا کردن علت مشترک معمولاً مؤثرتر از اصلاح جداگانه و تصادفی URLهاست.
جمعبندی
خطای Crawl در سرچ کنسول یک خطای واحد نیست، بلکه به مجموعهای از مشکلات مرتبط با دسترسی و خزیدن گوگل اشاره دارد. خطای 404، پاسخهای 5xx، مشکلات DNS، Timeout، ریدایرکتهای اشتباه و محدودیتهای robots.txt هرکدام علت و راهکار متفاوتی دارند. همچنین وضعیتهایی مانند Crawled – currently not indexed و Discovered – currently not indexed را نباید با خطاهای واقعی دسترسی یکسان دانست.
برای رفع اصولی مشکل، ابتدا URLهای درگیر و نوع خطا را در سرچ کنسول بررسی کنید؛ سپس با استفاده از URL Inspection، Page Indexing و Crawl Stats علت احتمالی را مشخص کنید. پس از اصلاح، وضعیت فعلی صفحه را دوباره آزمایش کنید و تنها برای URLهای مهم و در صورت نیاز درخواست ایندکس بفرستید.
در نهایت، به یاد داشته باشید که هدف اصلی، حذف تمام پیامهای سرچ کنسول نیست؛ بلکه اطمینان از دسترسی صحیح گوگل به صفحات مهم و برطرف کردن مشکلاتی است که واقعاً روی کشف، خزش یا ایندکس صفحات اثر میگذارند. اگر با خطاهای گسترده سرور، تنظیمات پیچیده Redirect یا مشکلات فنی وردپرس روبهرو هستید، بررسی تخصصی میتواند از تغییرات اشتباه و اتلاف زمان جلوگیری کند.
برای بررسی مشکلات فنی سایت، رفع خطاهای وردپرس و عیبیابی وضعیت Crawl و ایندکس، میتوانید با کارشناسان بخش پشتیبانی و تعمیرات سایت در مجموعه پرشیا وب ارتباط برقرار کنید.
